
これは必要?
「ローカル」には、ブラウザーで動くSSN内蔵音声と、自分で起動する音声サーバーの2種類があります。
| やりたいこと… | 操作 |
|---|---|
| インストール不要の無料音声 | 使用するもの: 内蔵音声。多くの人はここまでで十分です。 |
| 既に動かしている音声サーバーを使う | サーバーを接続する. |
| 複製した音声 | 参照: 音声の複製. |
| OBSでFish Audioを使う | 参照先: Fish Audioの設定. |
| 有料クラウド音声 | 参照先: TTSリファレンス. |
内蔵音声(インストール不要)
ブラウザーのSSN内で動作し、サーバー、Docker、APIキーは不要です。
| 音声 | 音質 | コンピューターの負荷 | リンクの値 |
|---|---|---|---|
| Kokoro | 優秀 | 中程度。GPUで高速化。 | ttsprovider=kokoro |
| Piper | とても良い | 低い。CPUのみ。 | ttsprovider=piper |
| Kitten | 良好 | 非常に低い。CPUのみ。 | ttsprovider=kitten |
| eSpeak-NG | 機械的 | 最小限。CPUのみ。 | ttsprovider=espeak |
4手順で設定する
- 追加する項目:
&speech=en-US&ttsprovider=kokoroの追加先:dock.htmlリンク(またはpiper,kitten,espeak.) - そのリンクをOBSの次のソースに追加します: ブラウザソース。音声を生成するのはそのページです。
- プロパティで次を有効にします: OBSで音声を制御する(Control audio via OBS).
- 短いテストチャットを送ります。例:
Testing local TTS.
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kokoro
独自のTTSサーバーを接続する
サーバーを使うと、音声の種類を増やしたり、音声を複製したり、複数ツールで同じ音声を使えます。SSNは次の方式で通信します: OpenAI互換 音声サーバー。APIキーは不要です。
- サーバーを起動します。 Kokoro-FastAPI が最も簡単です。
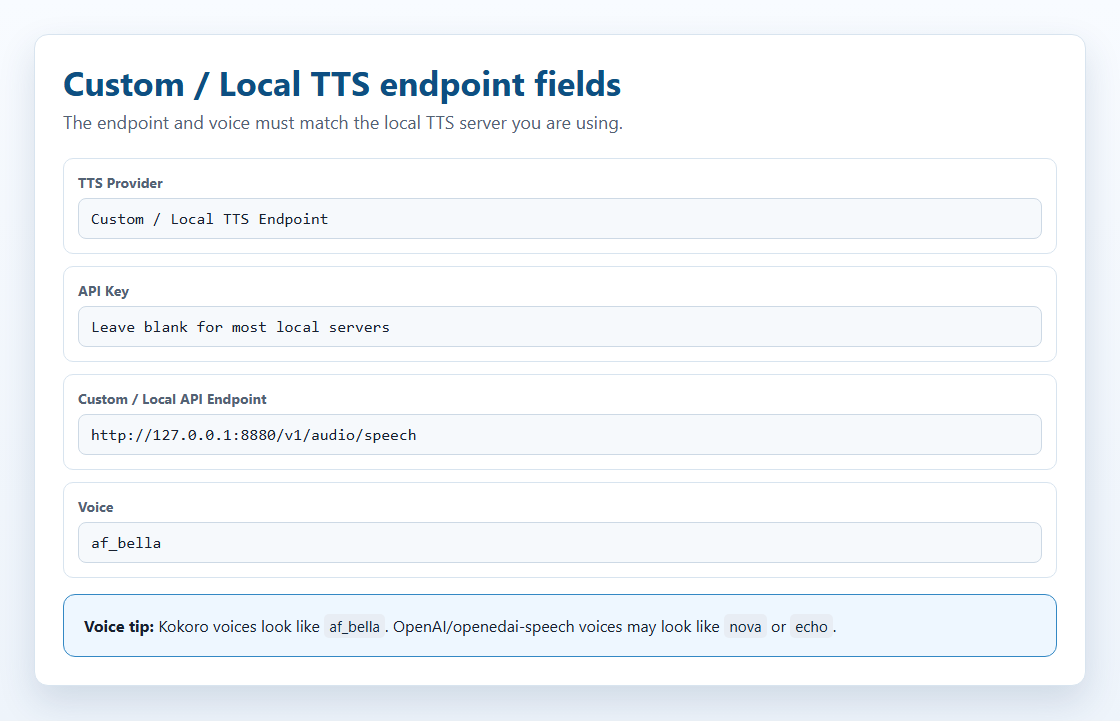
- SSNのTTSプロバイダー一覧を開き、次を選びます: カスタム/ローカルTTSエンドポイント(Custom / Local TTS Endpoint).
- 次の場所で: カスタム/ローカルAPIエンドポイントにサーバーのアドレスを入力します。例:
http://127.0.0.1:8880/v1/audio/speech. - APIキーは空欄にします。
- サーバーが対応する音声を選びます:
af_bellaをKokoro用に、novaをopenedai-speech用に使います。 - リンクをOBSにコピーし、テストチャットを送ります。
| サーバー | モデル | GPU | ディスク | ポート |
|---|---|---|---|---|
| Kokoro-FastAPI (推奨) | Kokoro 82M | 任意 | 約2GB | 8880 |
| openedai-speech (Piper) | Piper | CPUのみ | 1GB未満 | 8000 |
| kokoro-web | Kokoro 82M | 任意 | 約2GB | 3000 |
これらには次が必要です: Docker Desktop をインストールして起動する必要があります。個人利用は無料です。
localhostの意味
最もよくある間違いです。
localhost および 127.0.0.1 は常に「このコンピューター自身」を意味します。 OBSと音声サーバーが別のPCにある場合は、 127.0.0.1 はOBSのPCを指します。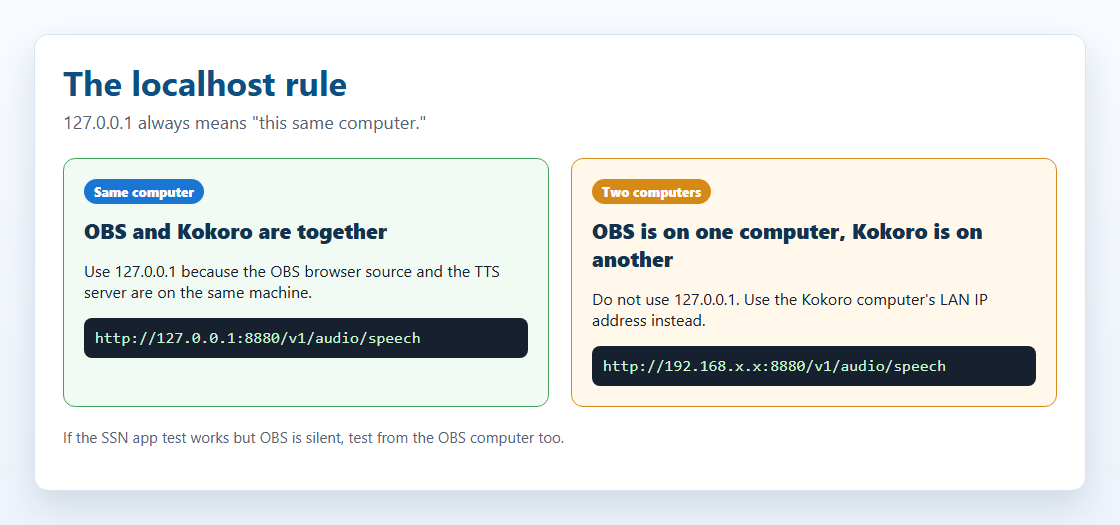
| 自分の構成 | 使うアドレス |
|---|---|
| OBSとサーバーが同じPC | http://127.0.0.1:8880/v1/audio/speech |
| 自宅の別PCにサーバーがある | http://192.168.x.x:8880/v1/audio/speechをそのPCのローカルIPに置き換えます: |
| SSNアプリのテストは成功するがOBSは無音 | OBSから使えるアドレスが必要です。アプリでの成功はOBSから接続できる証明にはなりません。 |
ファイアウォールでポートを許可し、Dockerが公開しているかも確認します(-p 8880:8880).
Kokoro-FastAPI
Kokoro-FastAPI はKokoroをローカルサーバーとして動かします。CPUで動作し、GPUは不要です。
- 端末(コマンドプロンプト、PowerShell、Terminal)で次のいずれかを実行します:
docker run -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:v0.2.2
NVIDIA GPU(高速):
docker run --gpus all -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-gpu:v0.2.0post4
初回だけ約1.5~2GBをダウンロードします。 - 開く項目:
http://localhost:8880/web/。67種類以上の音声をテストできるページが表示されるはずです。 - このリンクを使います(サーバーが別PCならアドレスを変更):
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8880/v1/audio/speech&voiceopenai=af_bella
af_bella, af_sarah, am_adam または bf_emma。次のようなOpenAIの名前は: nova または alloy は使えない場合があります。Dockerと一緒に自動起動する:
docker run -d --restart unless-stopped -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:v0.2.2
openedai-speech(PiperとXTTS-v2)
方法A:軽量Piperサーバー(CPU)
1GB未満。音声複製はできません。
docker run -d --restart unless-stopped -p 8000:8000 ghcr.io/matatonic/openedai-speech-min
音声: alloy, echo, fable, onyx, nova, shimmer.
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=openai&openaiendpoint=http://localhost:8000/v1/audio/speech&voiceopenai=nova
Windowsでソースから起動する場合(HTTP 500エラー)
仮想環境の次の項目を追加します: Scripts フォルダーを次へ: PATH を先に追加します。ないと次が見つかりません: piper.exe または ffmpeg.exe.
cd openedai-speech
$env:Path = "$PWD\.venv\Scripts;$env:Path"
.\.venv\Scripts\python.exe speech.py --xtts_device none -H 127.0.0.1 -P 8000
方法B:XTTS-v2の音声複製(GPU)
必要なのは完全なサーバーで、次ではありません: openedai-speech-min。GPUメモリ約4GBが目安です。CPUでも動きますが低速です。
4手順でXTTS-v2を設定する
- サーバーを取得して起動します:
git clone https://github.com/matatonic/openedai-speech.git
cd openedai-speech
Copy-Item sample.env speech.env
docker compose up -d
macOSまたはLinuxでは、次を使用します:cp sample.env speech.env。DockerからGPUを使える必要があります。モデルは初回にダウンロードされます。 - 使用許可のある音声で、雑音のない参照クリップを用意します。モノラル、22050Hz、6~30秒:
ffmpeg -i input.mp3 -ac 1 -ar 22050 -t 6 -y voices/me.wav
- 次の場所で:
config/voice_to_speaker.yamlでは、既存の次の項目の下に追加します:tts-1-hdセクションに追加します(既存音声は残します):tts-1-hd: me: model: xtts speaker: voices/me.wav language: en変更する項目:meをSSNが送る名前にします。 - 実行するコマンド:
docker compose restartを設定し、次を使います:dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8000/v1/audio/speech&openaimodel=tts-1-hd&voiceopenai=me&openaiformat=wav
openaimodel=tts-1-hd が必要です。 指定しなければSSNは次を送ります: tts-1にすると、サーバーは代わりにPiperを使います。 voiceopenai はYAMLファイルの音声名と一致させます。ブラウザーにブロックされる場合は次を起動します: ブリッジ を使い、次だけを変更します: openaiendpoint → http://127.0.0.1:8124/v1/audio/speech.
ローカルTTSブリッジ
SSNの小さな補助プログラムです。SSNのリクエストを音声サーバーへ転送し、ブラウザーが受け付ける形で音声を返します。Node.jsが必要です。
http://127.0.0.1:8124/v1/audio/speechを使います。音声サーバーが別のPCでも同じです。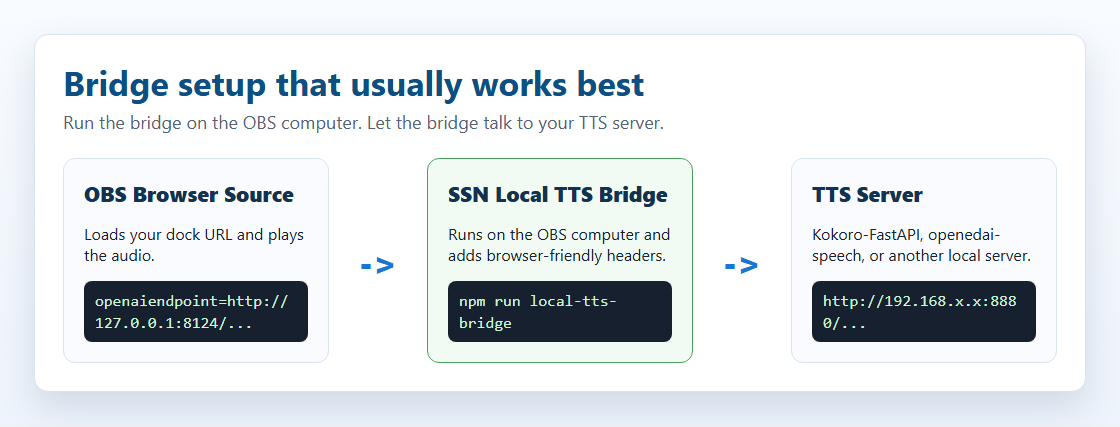
- ブリッジにサーバーの場所を指定します。PowerShell:
$env:SSN_TTS_TARGET="http://127.0.0.1:8880/v1/audio/speech"
サーバーが別PCなら、そのローカルIPを使います。例:http://192.168.x.x:8880/v1/audio/speech. - SSNフォルダーで次を実行します:
node scripts/local-tts-bridge.cjs。起動したままにしてください。 - SSNの接続先をブリッジにします:
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=af_bella
macOS/Linuxでは1行で: SSN_TTS_TARGET="http://127.0.0.1:8880/v1/audio/speech" node scripts/local-tts-bridge.cjs。次の中で: local-tts-bridge フォルダーで、 node server.cjs も同じ働きをします。ポートは次で変えます: SSN_TTS_BRIDGE_PORT=8125。全設定: ブリッジのREADME.
GPT-SoVITSモード
GPT-SoVITSは独自の次の形式を使用します: /tts 形式を使います。ブリッジが変換します。
$env:SSN_TTS_REF_AUDIO_PATH="C:\voices\speaker.wav"
$env:SSN_TTS_REF_TEXT="Reference audio transcript here."
$env:SSN_TTS_TARGET="http://127.0.0.1:9880/tts"
node scripts/local-tts-bridge.cjs --mode gptsovits
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&openaiformat=wav
F5-TTSサーバーモード
一部のF5-TTSラッパーは次を使います: /synthesize_speech/?text=...&voice=...。ブリッジが形式を変換します。
$env:SSN_TTS_TARGET="http://127.0.0.1:7860/synthesize_speech/"
node scripts/local-tts-bridge.cjs --mode f5
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=default_en&openaiformat=wav
音声クローン
音声の複製はSSNの設定ではなく、一部の音声サーバーの機能です。SSNがチャット本文を送り、サーバーが複製音声を選びます。
- 話者1人の、雑音の少ない明瞭な音声を通常3~30秒録音します。
- 音声で話した正確な文章が必要なサーバーもあります。
- サーバーが音声クリップから音声プロファイルを作ります。
- SSNはチャット本文を次で送ります:
ttsprovider=customtts. - サーバーが音声(通常WAVまたはMP3)を返し、SSNが再生します。
GPUメモリ6GB以下なら、OpenAI互換サーバーの小型モデルから始めます。大きなモデルも別の場所でホストすれば使えます。
| 選択肢 | 複製元 | 6GB GPUで使える? | 接続方法 |
|---|---|---|---|
| XTTS-v2 / openedai-speech | 短いWAV音声 | 対応、約4GB | 直接、 /v1/audio/speech。プロジェクトはアーカイブ済みです。 |
| chatterbox-tts-api / Chatterbox-TTS-Server | 参照音声 | Turboや短い分割ならおそらく可能 | 直接またはブリッジ経由。GPUはCPUより滑らかです。設定はフォークによって異なります。 |
| Qwen3-TTS (0.6B/1.7B) | 3秒の音声 | おそらく可能(0.6B Base) | OpenAI互換ラッパーが必要です。 |
| GPT-SoVITS | 5秒、1分あるとより良い | fp16/軽量構成ならおそらく可能 | ブリッジ(Bridge) --mode gptsovits. |
| F5-TTS | 音声とその文字起こし | 場合による | ラッパーまたはブリッジ --mode f5 付随する値: F5-TTS_server. |
| MisoTTS 8B | プロンプト用音声 | 不可。24GB推奨 | リモートホスティングのみ。リポジトリにローカルRESTエンドポイントはありません。 |
内蔵KokoroとKokoro-FastAPIは音声を複製しません。
SSNで確認した内容
次の両方で確認: dock.html および featured.html:
- openedai-speech (Piper):CPUでの実音声を、直接接続とブリッジ経由で確認。
- Chatterbox-TTS-Server:CPUでの実音声を次で確認:
Emily.wavを、直接接続とブリッジ経由の両方で確認しています。 - chatterbox-tts-api:直接接続とブリッジ経由でリクエスト形式を確認。
- GPT-SoVITS および F5-TTS_server:ブリッジモード経由のみ。
- F5-TTS公式 および Qwen3-TTS:先にラッパーが必要です(CLI、Gradio、ライブラリのみ)。
どんなコンピューターが必要?
大まかな目安で、保証ではありません。モデルサイズ、文章の長さ、ほかのアプリによってメモリ使用量は変わります。
| 選択肢 | 最低構成 | 余裕のある構成 |
|---|---|---|
| システムTTS/eSpeak | 任意のPC | 任意のPC |
| 組み込みKitten | 低性能のCPU、4GBのRAM | ノートPCのCPU、RAM 8GB |
| 組み込みPiper | 新しいCPU、RAM 4~8GB | 現代的なCPU、8GBのRAM |
| 組み込みKokoro | 現代的なCPU、8GBのRAM | WebGPU対応GPUまたは高速CPU、RAM 8~16GB |
| Kokoro-FastAPI | CPU、8GBのRAM | NVIDIA GPUは任意、RAM 8~16GB |
| openedai-speech Piper | CPU、RAM 4~8GB | CPU、8GBのRAM |
| openedai-speech XTTS | NVIDIA GPU 約4GB、RAM 8~16GB | 6GB以上のNVIDIA GPU、16GBのRAM |
| Chatterbox | 一部構成はCPU対応、低速 | 6GB以上のNVIDIA GPU、16GBのRAM |
| GPT-SoVITS / F5-TTS / Qwen3-TTS | テスト用CPU、低速 | 6GB以上のNVIDIA GPU、16GBのRAM |
| MisoTTS 8B | 6GBでは不可 | 24GB GPUまたはリモートホスト |
音声をOBSに取り込む
OBSブラウザーソース(推奨)
内蔵音声と独自サーバーで使えます。
- 追加する項目: ブラウザソース に自分の
dock.htmlTTSリンク。 - オンにする項目: OBSで音声を制御する(Control audio via OBS).
- クリックする項目: OK。TTSがOBSミキサーに表示されます。
SSNデスクトップアプリ
デスクトップアプリも同じリンク設定を使いますが、音はOBSではなくアプリから出ます。次で取り込みます: デスクトップ音声 または 音声入力キャプチャ(Audio Input Capture)。TTSをほかの音と分けるには、アプリの音声を仮想ケーブルへ送ります: 音声経路の設定手順.
デスクトップアプリの詳細
アプリのウィンドウはChromeよりブラウザー権限(CORS)の制約が緩やかです。ブラウザーからのリクエストを拒否するサーバーには、ブリッジが最も確実です。内蔵Kokoroでは、アプリ独自の次の経路を使えます: ninjafy.tts 経路を使い、ブラウザー内にモデルを読み込まずに済みます。
&speech=en-US でプロバイダー未指定の場合)はOBSにある音声に依存します。音声がない、または取り込める音が出ないことがあります。代わりに上記プロバイダーを使ってください。比較
| 選択肢 | 設定 | 品質 | 非公開 | OBS対応 | 費用 |
|---|---|---|---|---|---|
| 組み込みKokoro | なし | 5/5 | はい | はい | 無料 |
| 組み込みPiper | なし | 4/5 | はい | はい | 無料 |
| 組み込みKitten | なし | 3/5 | はい | はい | 無料 |
| 組み込みeSpeak | なし | 2/5 | はい | はい | 無料 |
| Kokoro-FastAPI | Docker | 5/5 | はい | はい | 無料 |
| openedai-speech | Docker | 4/5 | はい | はい | 無料 |
| ElevenLabs | APIキー | 5/5 | 不要 | はい | 有料プラン |
| システム読み上げ(System TTS) | なし | 2/5 | はい | 音声経路の設定が必要 | 無料 |
問題を解決する
| 問題 | 試すこと |
|---|---|
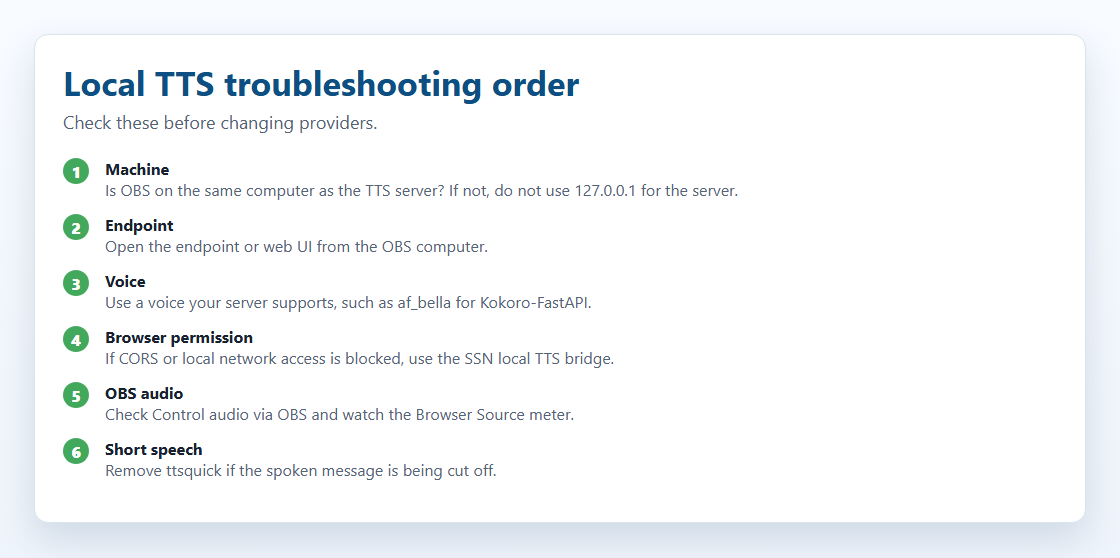
| アプリのテストは動くがOBSは無音 | OBS自身がサーバーに接続する必要があります。別PCの場合は、次を置き換えます: 127.0.0.1 をローカルIPに置き換えます。確認する項目: OBSで音声を制御する(Control audio via OBS)。まだブロックされる場合は、OBSのPCでブリッジを起動します。 |
| 最初の文字や単語しか読まれない | 削除 ttsquick をOBSのリンクから外します(例: &ttsquick=14)を外して再読み込みします。テスト中は次も外します: typewriter= でタイミングの問題を切り分けます。 |
| サーバーが応答しない | Dockerとコンテナーが起動しているか確認します。サーバーのPCで次を開きます: http://127.0.0.1:8880/web/ (Kokoro-FastAPI、または使用サーバーのポート)。OBSのPCから次を開きます: http://SERVER_LAN_IP:8880/web/。失敗したらOBSも接続できません。サーバーのファイアウォールを確認します。 |
| 「CORSでブロック」「private network」「failed fetch」 | サーバーに届く前にブラウザーがブロックしました。次を起動します: node scripts/local-tts-bridge.cjs をOBSのPCで起動し、次を使います: http://127.0.0.1:8124/v1/audio/speech。公開ベータ版のDockはブロックされやすいため、ブリッジやローカルアプリのウィンドウを使う方が簡単です。 |
| 違う音声になる/音声が見つからない | Kokoro-FastAPI: af_bella, af_sarah, am_adam、またはそのWebページから選びます。openedai-speechの場合: nova, echo, alloy。大文字と小文字を区別するサーバーもあります。 |
| 再生するがOBSに入らない | オンにする項目: OBSで音声を制御する(Control audio via OBS)。テスト中にOBSミキサーのメーターを確認します。次を設定してください: &ttsprovider=。System TTSにはデスクトップ音声や仮想ケーブルが必要な場合があります。 |
| Dockerイメージが見つからない | イメージのタグは変わります。現在のタグを次で確認してください: Kokoro-FastAPI または openedai-speech. |
サーバー開発者向け
SSNと独自サーバーの通信方法です。サーバーの作成やデバッグ時にだけ必要です。
chat text -> SSN -> your endpoint (or the bridge) -> TTS server -> audio -> SSN plays it
SSNが送るもの
次の設定では: ttsprovider=customtts, localtts または openaiを使い、SSNはJSONのPOSTを送ります:
POST /v1/audio/speech
{
  "model": "tts-1",
  "input": "Chat message text",
  "voice": "af_bella",
  "response_format": "mp3",
  "speed": 1.0
}
APIキーが未設定なら、SSNはAuthorizationヘッダーを送りません。
SSNが再生できるもの
| 応答 | 動作する? | 補足 |
|---|---|---|
| 音声ファイル | はい | 最良。 audio/mpeg, audio/wav, audio/ogg, audio/aac、またはブラウザーで再生できる形式。 |
| 音声URLを含むJSON | はい | 確認内容 url, audio_url, output_url, data.url、および最初の data[] の項目。 |
| Base64音声を含むJSON | はい | 確認内容 audio, audio_data, audioContent, b64_json、入れ子になった data フィールド、およびデータURL。 |
| 生のPCM | ラッパーを使用する場合のみ | WAVファイルまたはbase64のWAVとして送ります。 |
形式: mp3 は小さく、広く対応されています。 wav は音声複製サーバーやブリッジのテストに向いています。次を使います: opus はサーバーとブラウザーの両方が対応する場合のみ使います。
ストリーミングは未対応です。 SSNは応答全体を待ってから再生します。チャットは短くしてください。
独自サーバーのリンク設定
| 設定 | 例 | 動作 |
|---|---|---|
ttsprovider | customtts | 独自サーバーを使います(openai も使えます)。 |
openaiendpoint | http://localhost:8880/v1/audio/speech | サーバーのアドレス。ポートはサーバーに合わせます。 |
speech | en-US | 英語でTTSを有効にします。 |
voiceopenai | af_bella | 音声名。サーバーによって異なります。 |
openaimodel | tts-1-hd | モデル名。標準は tts-1. |
openaiformat | mp3 | mp3、wav、opus、flac。 |
openaispeed | 1.0 | 読み上げ速度(0.5~2.0)。 |
次も対応: customttsendpoint, localttsendpoint, customttsvoice, localttsvoice, customttsmodel, localttsmodel, customttsformat, localttsformat。読み上げ設定、たとえば simpletts, skipmessages および ttsquick はどのプロバイダーでも使えます: すべてのリンク設定.
リンク例:
Kokoro-FastAPI:  dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:8880/v1/audio/speech&voiceopenai=af_bella&openaispeed=1.1
openedai-speech: dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:8000/v1/audio/speech&voiceopenai=nova
kokoro-web:      dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:3000/api/v1/audio/speech&voiceopenai=af_bella