
이 기능이 필요한가요?
'로컬'은 브라우저에서 실행되는 SSN 내장 음성 또는 직접 운영하는 음성 서버를 뜻합니다.
| 원하는 것… | 할 작업 |
|---|---|
| 설치 없는 무료 음성 | 사용: 내장 음성. 대부분은 여기까지만 하면 됩니다. |
| 이미 실행 중인 음성 서버 사용 | 서버 연결. |
| 복제한 음성 | 참고: 음성 복제. |
| OBS의 Fish Audio | 다음을 참조하세요: Fish Audio 설정. |
| 유료 클라우드 음성 | 다음을 참조하세요: TTS 참조. |
내장 음성(설치 불필요)
브라우저의 SSN 안에서 실행됩니다. 서버, Docker, API 키가 필요 없습니다.
| 음성 | 음질 | 컴퓨터 부하 | 링크 값 |
|---|---|---|---|
| Kokoro | 매우 뛰어남 | 중간. GPU로 더 빠름. | ttsprovider=kokoro |
| Piper | 아주 좋음 | 낮음. CPU만 사용. | ttsprovider=piper |
| Kitten | 좋음 | 매우 낮음. CPU만 사용. | ttsprovider=kitten |
| eSpeak-NG | 기계음 | 최소. CPU만 사용. | ttsprovider=espeak |
4단계 설정
- 추가:
&speech=en-US&ttsprovider=kokoro— 추가할 위치:dock.html링크(또는piper,kitten,espeak.) - 링크를 OBS의 다음 소스로 추가하세요: 브라우저 소스. 소리를 만드는 페이지입니다.
- 속성에서 다음을 켜세요: OBS를 통해 오디오 제어(Control audio via OBS).
- 짧은 테스트 채팅을 보내세요. 예:
Testing local TTS.
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kokoro
자체 TTS 서버 연결
서버를 쓰면 더 많은 음성, 음성 복제, 여러 도구에서 재사용하는 음성을 얻습니다. SSN은 다음처럼 통신합니다: OpenAI 호환 음성 서버. API 키가 필요 없습니다.
- 서버를 시작하세요. Kokoro-FastAPI 이 가장 쉽습니다.
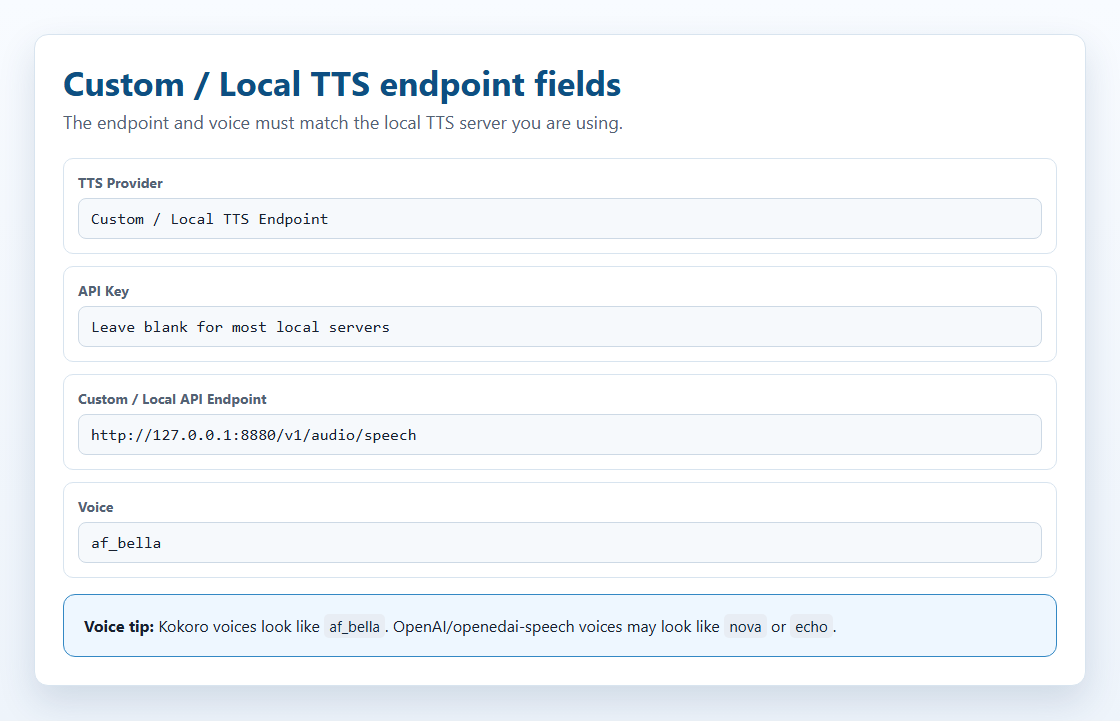
- SSN에서 TTS 제공자 목록을 열고 다음을 고르세요: 사용자 지정 / 로컬 음성 읽기 엔드포인트 (Custom / Local TTS Endpoint).
- 다음 위치에서: 사용자 지정 / 로컬 API 엔드포인트에 서버 주소를 입력하세요. 예:
http://127.0.0.1:8880/v1/audio/speech. - API 키는 비워 두세요.
- 서버가 아는 음성을 선택하세요:
af_bella은 Kokoro용,nova은 openedai-speech용입니다. - 링크를 OBS에 복사하고 테스트 채팅을 보내세요.
| 서버 | 모델 | GPU | 디스크 | 포트 |
|---|---|---|---|---|
| Kokoro-FastAPI (권장) | Kokoro 82M | 선택 사항 | 약 2 GB | 8880 |
| openedai-speech (Piper) | Piper | CPU 전용 | 1 GB 미만 | 8000 |
| kokoro-web | Kokoro 82M | 선택 사항 | 약 2 GB | 3000 |
다음이 필요합니다: Docker Desktop 을 설치하고 실행해야 합니다. 개인용으로 무료입니다.
localhost 규칙
가장 흔한 실수입니다.
localhost 그리고 127.0.0.1 은 항상 '이 컴퓨터 자체'를 뜻합니다. OBS와 음성 서버가 서로 다른 PC에 있다면, 127.0.0.1 은 OBS PC를 가리킵니다.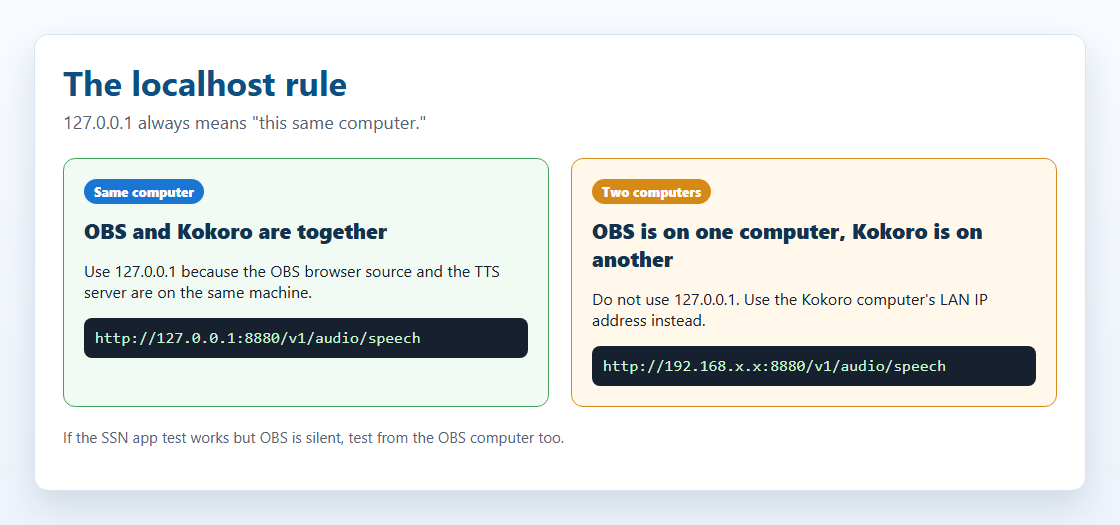
| 사용 환경 | 사용할 주소 |
|---|---|
| OBS와 서버가 같은 PC | http://127.0.0.1:8880/v1/audio/speech |
| 집 안의 다른 PC에 있는 서버 | http://192.168.x.x:8880/v1/audio/speech을 해당 PC의 로컬 IP로 바꾸세요: |
| SSN 앱 테스트는 되지만 OBS는 무음 | OBS에서 작동하는 주소가 필요합니다. 앱 테스트가 OBS의 서버 접근을 증명하지는 않습니다. |
방화벽이 포트를 허용하고 Docker가 공개했는지도 확인하세요(-p 8880:8880).
Kokoro-FastAPI
Kokoro-FastAPI 은 Kokoro를 로컬 서버로 실행합니다. CPU에서 작동하며 GPU는 필요 없습니다.
- 터미널(명령 프롬프트, PowerShell 또는 Terminal)을 열고 다음 중 하나를 실행하세요:
docker run -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:v0.2.2
NVIDIA GPU(더 빠름):
docker run --gpus all -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-gpu:v0.2.0post4
첫 실행에 한 번만 약 1.5~2GB를 내려받습니다. - 열기
http://localhost:8880/web/. 음성 67개 이상을 시험하는 페이지가 보여야 합니다. - 이 링크를 쓰세요(서버가 다른 PC면 주소 변경):
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8880/v1/audio/speech&voiceopenai=af_bella
af_bella, af_sarah, am_adam 또는 bf_emma. 다음과 같은 OpenAI 이름은: nova 또는 alloy 은 작동하지 않을 수 있습니다.Docker와 함께 자동 시작:
docker run -d --restart unless-stopped -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:v0.2.2
openedai-speech(Piper 및 XTTS-v2)
방법 A: 가벼운 Piper 서버(CPU)
1GB 미만. 음성 복제 없음.
docker run -d --restart unless-stopped -p 8000:8000 ghcr.io/matatonic/openedai-speech-min
음성: alloy, echo, fable, onyx, nova, shimmer.
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=openai&openaiendpoint=http://localhost:8000/v1/audio/speech&voiceopenai=nova
Windows에서 소스로 실행(HTTP 500 오류)
가상 환경의 다음을 추가하세요: Scripts 폴더를 다음에 추가: PATH 을 먼저 추가하세요. 없으면 다음을 찾지 못합니다: piper.exe 또는 ffmpeg.exe.
cd openedai-speech
$env:Path = "$PWD\.venv\Scripts;$env:Path"
.\.venv\Scripts\python.exe speech.py --xtts_device none -H 127.0.0.1 -P 8000
방법 B: XTTS-v2 음성 복제(GPU)
다음이 아닌 전체 서버가 필요합니다: openedai-speech-min. GPU 메모리 약 4GB를 예상하세요. CPU도 되지만 느립니다.
4단계로 XTTS-v2 설정
- 서버를 받아 시작하세요:
git clone https://github.com/matatonic/openedai-speech.git
cd openedai-speech
Copy-Item sample.env speech.env
docker compose up -d
macOS 또는 Linux에서는 다음을 사용하세요:cp sample.env speech.env. Docker가 GPU에 접근할 수 있어야 합니다. 모델은 처음 사용할 때 내려받습니다. - 사용 허가를 받은 음성으로 깨끗한 참조 클립을 만드세요. 모노, 22050Hz, 6~30초:
ffmpeg -i input.mp3 -ac 1 -ar 22050 -t 6 -y voices/me.wav
- 다음 위치에서:
config/voice_to_speaker.yaml에서는 기존 다음 항목 아래에 추가하세요:tts-1-hd섹션에 추가하세요(기존 음성 유지):tts-1-hd: me: model: xtts speaker: voices/me.wav language: en변경할 항목:me을 SSN이 보낼 이름으로 바꾸세요. - 실행:
docker compose restart을 설정한 뒤 다음을 사용하세요:dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8000/v1/audio/speech&openaimodel=tts-1-hd&voiceopenai=me&openaiformat=wav
openaimodel=tts-1-hd 이 필요합니다. 없으면 SSN은 다음을 보냅니다: tts-1이면 서버가 Piper를 대신 사용합니다. voiceopenai 은 YAML 파일의 음성 이름과 일치해야 합니다.브라우저에 차단되면 다음을 실행하세요: 브리지 을 쓰고 다음만 바꾸세요: openaiendpoint 대상: http://127.0.0.1:8124/v1/audio/speech.
로컬 TTS 브리지
SSN의 작은 도우미입니다. SSN 요청을 음성 서버로 전달하고 브라우저가 받아들이는 형식으로 오디오를 돌려줍니다. Node.js가 필요합니다.
http://127.0.0.1:8124/v1/audio/speech을 사용합니다. 음성 서버가 다른 PC에 있어도 같습니다.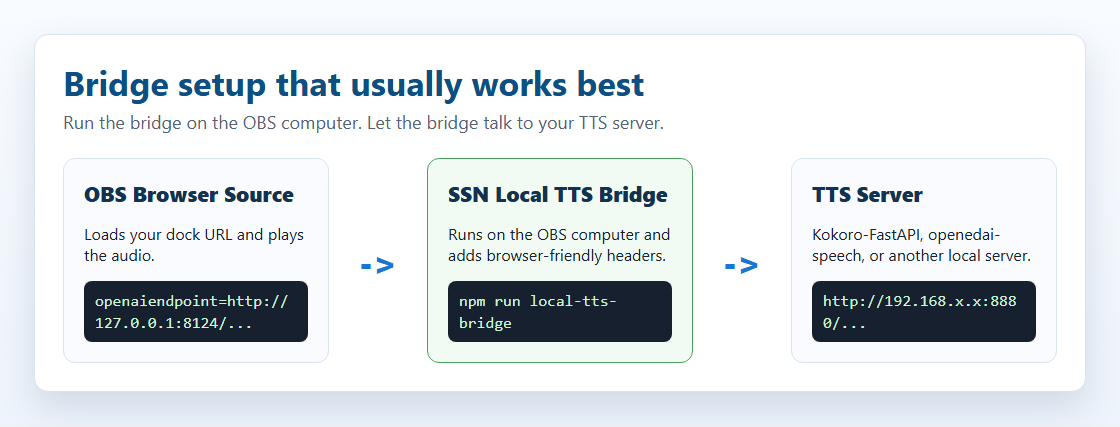
- 브리지에 서버 위치를 알려 주세요. PowerShell:
$env:SSN_TTS_TARGET="http://127.0.0.1:8880/v1/audio/speech"
서버가 다른 PC면 로컬 IP를 쓰세요. 예:http://192.168.x.x:8880/v1/audio/speech. - SSN 폴더에서 다음을 실행하세요:
node scripts/local-tts-bridge.cjs. 계속 실행해 두세요. - SSN이 브리지를 향하도록 설정하세요:
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=af_bella
macOS/Linux에서는 한 줄로: SSN_TTS_TARGET="http://127.0.0.1:8880/v1/audio/speech" node scripts/local-tts-bridge.cjs. 다음 내부에서: local-tts-bridge 폴더에서, node server.cjs 도 같습니다. 포트는 다음으로 바꾸세요: SSN_TTS_BRIDGE_PORT=8125. 모든 옵션: 브리지 README.
GPT-SoVITS 모드
GPT-SoVITS는 자체 /tts 형식을 사용합니다. 브리지가 변환합니다.
$env:SSN_TTS_REF_AUDIO_PATH="C:\voices\speaker.wav"
$env:SSN_TTS_REF_TEXT="Reference audio transcript here."
$env:SSN_TTS_TARGET="http://127.0.0.1:9880/tts"
node scripts/local-tts-bridge.cjs --mode gptsovits
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&openaiformat=wav
F5-TTS 서버 모드
일부 F5-TTS 래퍼는 다음을 사용합니다: /synthesize_speech/?text=...&voice=.... 브리지가 형식을 변환합니다.
$env:SSN_TTS_TARGET="http://127.0.0.1:7860/synthesize_speech/"
node scripts/local-tts-bridge.cjs --mode f5
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=default_en&openaiformat=wav
음성 복제
음성 복제는 SSN 설정이 아니라 일부 음성 서버의 기능입니다. SSN은 채팅을 보내고 서버가 복제 음성을 고릅니다.
- 보통 3~30초 길이로, 배경 소음이 적은 한 사람의 깨끗한 음성을 녹음하세요.
- 일부 서버는 클립에서 말한 정확한 문장도 필요합니다.
- 서버가 클립을 음성 프로필로 만듭니다.
- SSN은 채팅을 다음으로 보냅니다:
ttsprovider=customtts. - 서버가 오디오(보통 WAV 또는 MP3)를 반환하고 SSN이 재생합니다.
GPU 메모리가 6GB 이하라면 OpenAI 호환 서버의 작은 모델로 시작하세요. 큰 모델도 다른 곳에서 호스팅하면 작동합니다.
| 옵션 | 복제 원본 | 6GB GPU에 맞나요? | 연결 방법 |
|---|---|---|---|
| XTTS-v2 / openedai-speech | 짧은 WAV 클립 | 예, 약 4GB | 직접, /v1/audio/speech. 보관 처리된 프로젝트입니다. |
| chatterbox-tts-api / Chatterbox-TTS-Server | 참조 클립 | Turbo 또는 작은 분할이면 가능성 높음 | 직접 또는 브리지 연결. GPU가 CPU보다 매끄럽습니다. 설정은 포크마다 다릅니다. |
| Qwen3-TTS (0.6B / 1.7B) | 3초 클립 | 가능성 높음(0.6B Base) | OpenAI 호환 래퍼가 필요합니다. |
| GPT-SoVITS | 5초, 1분이면 더 좋음 | fp16 / 가벼운 설치면 가능성 높음 | 브리지 (Bridge) --mode gptsovits. |
| F5-TTS | 클립과 대본 | 경우에 따라 가능 | 래퍼 또는 브리지 --mode f5 포함: F5-TTS_server. |
| MisoTTS 8B | 프롬프트 오디오 | 아니요, 24GB 권장 | 원격 호스팅만 지원. 저장소에 로컬 REST 엔드포인트가 없습니다. |
내장 Kokoro와 Kokoro-FastAPI는 음성을 복제하지 않습니다.
SSN으로 테스트한 내용
다음 둘 다 확인: dock.html 그리고 featured.html:
- openedai-speech (Piper): 직접 연결과 브리지로 실제 CPU 음성 확인.
- Chatterbox-TTS-Server: 다음으로 실제 CPU 음성 확인:
Emily.wav를 직접 연결과 브리지 연결로 시험했습니다. - chatterbox-tts-api: 직접 연결과 브리지로 요청 형식 테스트.
- GPT-SoVITS 그리고 F5-TTS_server: 브리지 모드로만 연결.
- F5-TTS 공식 그리고 Qwen3-TTS: 먼저 래퍼 필요(CLI, Gradio 또는 라이브러리만 제공).
어떤 컴퓨터가 필요한가요?
대략적인 출발점이며 보장은 아닙니다. 모델 크기, 텍스트 길이, 다른 앱에 따라 메모리 사용량이 달라집니다.
| 옵션 | 최소 사양 | 여유 있는 사양 |
|---|---|---|
| 시스템 음성 읽기 / eSpeak | 모든 PC | 모든 PC |
| 내장 Kitten | 저사양 CPU, RAM 4 GB | 노트북 CPU, RAM 8GB |
| 내장 Piper | 최신 CPU, RAM 4~8GB | 최신 CPU, RAM 8 GB |
| 내장 Kokoro | 최신 CPU, RAM 8 GB | WebGPU GPU 또는 빠른 CPU, RAM 8~16GB |
| Kokoro-FastAPI | CPU, RAM 8 GB | NVIDIA GPU 선택 사항, RAM 8~16GB |
| openedai-speech Piper | CPU, RAM 4~8GB | CPU, RAM 8 GB |
| openedai-speech XTTS | NVIDIA GPU 약 4GB, RAM 8~16GB | VRAM 6 GB 이상 NVIDIA GPU, RAM 16 GB |
| Chatterbox | 일부 빌드에서 CPU, 느림 | VRAM 6 GB 이상 NVIDIA GPU, RAM 16 GB |
| GPT-SoVITS / F5-TTS / Qwen3-TTS | 테스트용 CPU, 느림 | VRAM 6 GB 이상 NVIDIA GPU, RAM 16 GB |
| MisoTTS 8B | 6GB에서는 불가 | 24GB GPU 또는 원격 호스트 |
오디오를 OBS로 보내기
OBS 브라우저 소스(권장)
내장 음성과 자체 서버에서 작동합니다.
- 추가: 브라우저 소스 에 본인의
dock.htmlTTS 링크. - 켜기: OBS를 통해 오디오 제어(Control audio via OBS).
- 클릭: 확인. 이제 TTS가 OBS 믹서에 표시됩니다.
SSN 데스크톱 앱
데스크톱 앱도 같은 링크 설정을 쓰지만 소리는 OBS가 아닌 앱에서 나옵니다. 다음으로 캡처하세요: 데스크톱 오디오 또는 오디오 입력 캡처. TTS를 다른 소리와 분리하려면 앱을 가상 케이블로 보내세요: 라우팅 단계.
데스크톱 앱 자세히
앱 창은 Chrome보다 브라우저 권한(CORS) 제약이 적습니다. 브라우저 요청을 거절하는 서버에는 브리지가 가장 안전한 선택입니다. 내장 Kokoro는 앱 자체의 다음 경로를 사용할 수 있습니다: ninjafy.tts 경로를 사용해 브라우저에서 모델을 로드하지 않아도 됩니다.
&speech=en-US 만 있고 제공자가 없는 경우)는 OBS의 음성에 의존합니다. 없거나 캡처 가능한 소리를 내지 않는 경우가 많습니다. 위의 제공자를 대신 쓰세요.나란히 비교
| 옵션 | 설정 | 품질 | 비공개 | OBS에서 작동 | 비용 |
|---|---|---|---|---|---|
| 내장 Kokoro | 없음 | 5/5 | 예 | 예 | 무료 |
| 내장 Piper | 없음 | 4/5 | 예 | 예 | 무료 |
| 내장 Kitten | 없음 | 3/5 | 예 | 예 | 무료 |
| 내장 eSpeak | 없음 | 2/5 | 예 | 예 | 무료 |
| Kokoro-FastAPI | Docker | 5/5 | 예 | 예 | 무료 |
| openedai-speech | Docker | 4/5 | 예 | 예 | 무료 |
| ElevenLabs | API 키 | 5/5 | 아니요 | 예 | 유료 요금제 |
| 시스템 음성 읽기 | 없음 | 2/5 | 예 | 오디오 라우팅 필요 | 무료 |
문제 해결
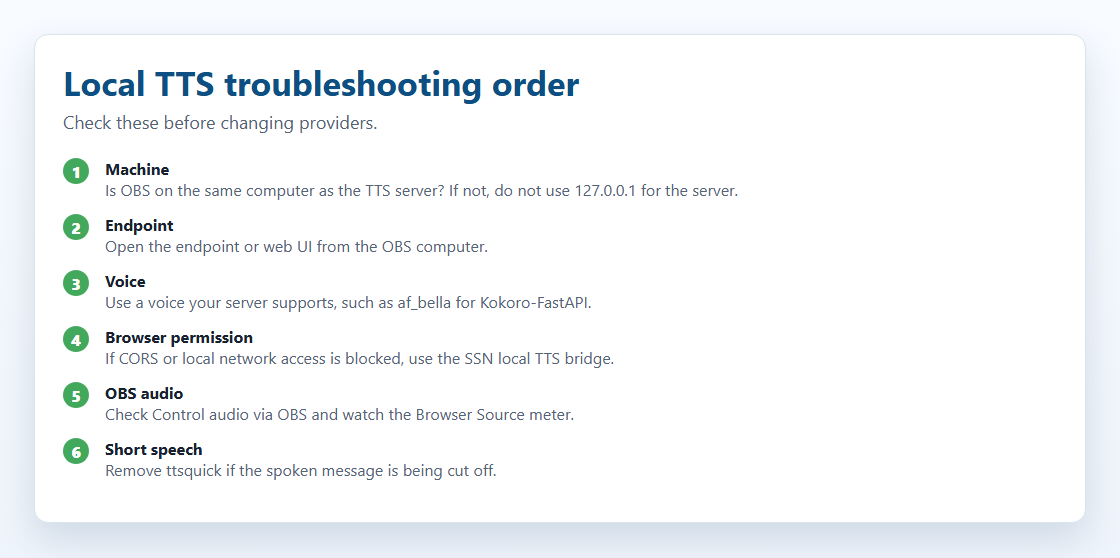
| 문제 | 시도할 방법 |
|---|---|
| 앱 테스트는 되지만 OBS는 무음 | OBS가 직접 서버에 접근해야 합니다. 서버가 다른 PC라면 다음을 바꾸세요: 127.0.0.1 을 로컬 IP로 바꾸세요. 확인할 항목: OBS를 통해 오디오 제어(Control audio via OBS). 계속 막히면 OBS PC에서 브리지를 실행하세요. |
| 첫 글자나 단어만 읽음 | 제거 ttsquick 을 OBS 링크에서 제거하세요(예: &ttsquick=14)을 제거하고 새로 고침하세요. 테스트 중에는 다음도 제거하세요: typewriter= 으로 타이밍 문제를 배제하세요. |
| 서버가 응답하지 않음 | Docker와 컨테이너가 실행 중인지 확인하세요. 서버 PC에서 다음을 여세요: http://127.0.0.1:8880/web/ (Kokoro-FastAPI 또는 서버의 포트). OBS PC에서 다음을 여세요: http://SERVER_LAN_IP:8880/web/. 실패하면 OBS도 연결하지 못합니다. 서버 방화벽을 확인하세요. |
| 'Blocked by CORS', 'private network' 또는 'failed fetch' | 서버에 도착하기 전에 브라우저가 차단했습니다. 다음을 실행하세요: node scripts/local-tts-bridge.cjs 을 OBS PC에서 실행하고 다음을 쓰세요: http://127.0.0.1:8124/v1/audio/speech. 호스팅된 베타 Dock 페이지는 더 쉽게 차단되므로 브리지나 로컬 앱 창이 더 쉽습니다. |
| 음성이 다르거나 찾을 수 없음 | Kokoro-FastAPI: af_bella, af_sarah, am_adam또는 웹페이지의 음성을 사용하세요. openedai-speech: nova, echo, alloy. 일부 서버는 대소문자를 구분합니다. |
| 재생되지만 OBS가 캡처하지 못함 | 켜기: OBS를 통해 오디오 제어(Control audio via OBS). 테스트 중 OBS 믹서 미터를 보세요. 다음을 설정해야 합니다: &ttsprovider=. System TTS는 데스크톱 오디오나 가상 케이블이 필요할 수 있습니다. |
| Docker 이미지를 찾을 수 없음 | 이미지 태그는 바뀝니다. 최신 태그는 다음에서 확인하세요: Kokoro-FastAPI 또는 openedai-speech. |
서버 개발자용
SSN이 맞춤 서버와 통신하는 방식입니다. 서버를 만들거나 디버깅할 때만 필요합니다.
chat text -> SSN -> your endpoint (or the bridge) -> TTS server -> audio -> SSN plays it
SSN이 보내는 것
다음을 사용하면: ttsprovider=customtts, localtts 또는 openai을 사용하며 SSN은 JSON POST를 보냅니다:
POST /v1/audio/speech
{
  "model": "tts-1",
  "input": "Chat message text",
  "voice": "af_bella",
  "response_format": "mp3",
  "speed": 1.0
}
API 키가 없으면 SSN은 Authorization 헤더를 보내지 않습니다.
SSN이 재생할 수 있는 것
| 응답 | 작동 여부 | 참고 |
|---|---|---|
| 오디오 파일 | 예 | 최상. audio/mpeg, audio/wav, audio/ogg, audio/aac또는 브라우저에서 재생 가능한 형식. |
| 오디오 URL이 담긴 JSON | 예 | 검사 url, audio_url, output_url, data.url, 그리고 첫 번째 data[] 항목입니다. |
| base64 오디오가 포함된 JSON | 예 | 검사 audio, audio_data, audioContent, b64_json, 중첩된 data 필드와 데이터 URL입니다. |
| 원시 PCM | 래퍼를 사용하는 경우에만 | WAV 파일 또는 base64 WAV로 보내세요. |
형식: mp3 은 작고 널리 지원됩니다. wav 은 복제 서버와 브리지 테스트에 적합합니다. 다음을 사용하세요: opus 은 서버와 브라우저가 모두 지원할 때만 쓰세요.
아직 스트리밍은 없습니다. SSN은 전체 응답을 기다린 뒤 재생합니다. 채팅 메시지를 짧게 유지하세요.
자체 서버용 링크 설정
| 설정 | 예시 | 역할 |
|---|---|---|
ttsprovider | customtts | 자체 서버를 사용합니다(openai 도 작동합니다.) |
openaiendpoint | http://localhost:8880/v1/audio/speech | 서버 주소. 포트를 맞게 바꾸세요. |
speech | en-US | 영어로 TTS를 켭니다. |
voiceopenai | af_bella | 음성 이름. 서버에 따라 다름. |
openaimodel | tts-1-hd | 모델 이름. 기본값 tts-1. |
openaiformat | mp3 | mp3, wav, opus 또는 flac. |
openaispeed | 1.0 | 읽기 속도(0.5~2.0). |
다음도 지원: customttsendpoint, localttsendpoint, customttsvoice, localttsvoice, customttsmodel, localttsmodel, customttsformat, localttsformat. 다음과 같은 읽기 옵션은: simpletts, skipmessages 그리고 ttsquick 은 모든 제공자에서 작동합니다: 모든 링크 설정.
예시 링크:
Kokoro-FastAPI:  dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:8880/v1/audio/speech&voiceopenai=af_bella&openaispeed=1.1
openedai-speech: dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:8000/v1/audio/speech&voiceopenai=nova
kokoro-web:      dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://localhost:3000/api/v1/audio/speech&voiceopenai=af_bella