Genel bakış
Social Stream Ninja, yerel yapay zekâ metinden konuşmaya özelliğiyle sohbet mesajlarını sesli okuyabilir. “Yerel” iki anlama gelebilir: ses tarayıcı içinde çalışır veya kendi bilgisayarınızda küçük bir TTS sunucusu çalıştırırsınız.
İki yaklaşım vardır:
Yol 1 — Yerleşik TTS Kurulum Yok
Çeşitli yüksek kaliteli yapay zekâ sesleri doğrudan Social Stream Ninja içine yerleştirilmiştir. WebAssembly veya ONNX kullanarak tarayıcınızda çalışırlar — sunucu, Docker veya kurulum gerekmez.
- Kokoro 82M (en iyi kalite)
- Piper Sinir Ağı TTS
- Kitten TTS
- eSpeak-NG
Yalnızca bir URL parametresi ekleyip başlayın.
Yol 2 — Kendi Barındırdığınız Sunucu Docker Gerekli
Bilgisayarınızda yerel bir TTS sunucusu çalıştırın ve Social Stream Ninja'yı ona yönlendirin. Daha fazla ses seçeneği, ses klonlama ve sunucu tarafı kontrol sağlar.
- Kokoro-FastAPI
- openedai-speech (Piper)
- kokoro-web
Social Stream'in yerleşik özelliğini kullanır: OpenAI uyumlu uç nokta desteği.
Hızlı Kurulum
Çoğu yayıncı için en kısa yol budur:
&speech=en-US&ttsprovider=kokoro veya &speech=en-US&ttsprovider=kitten şuraya: dock.html URL'si.Testing local TTS. Kokoro veya Piper kullanıyorsanız ilk model indirmelerinin tamamlanmasını bekleyin.localhost / 127.0.0.1 Kuralı
En yaygın yerel TTS hatası budur.
localhost ve 127.0.0.1 her zaman “bu bilgisayar” anlamına gelir. OBS bir bilgisayarda, Kokoro başka bir bilgisayardaysa, 127.0.0.1 OBS URL'sinin içinde Kokoro bilgisayarını değil, OBS bilgisayarını gösterir.
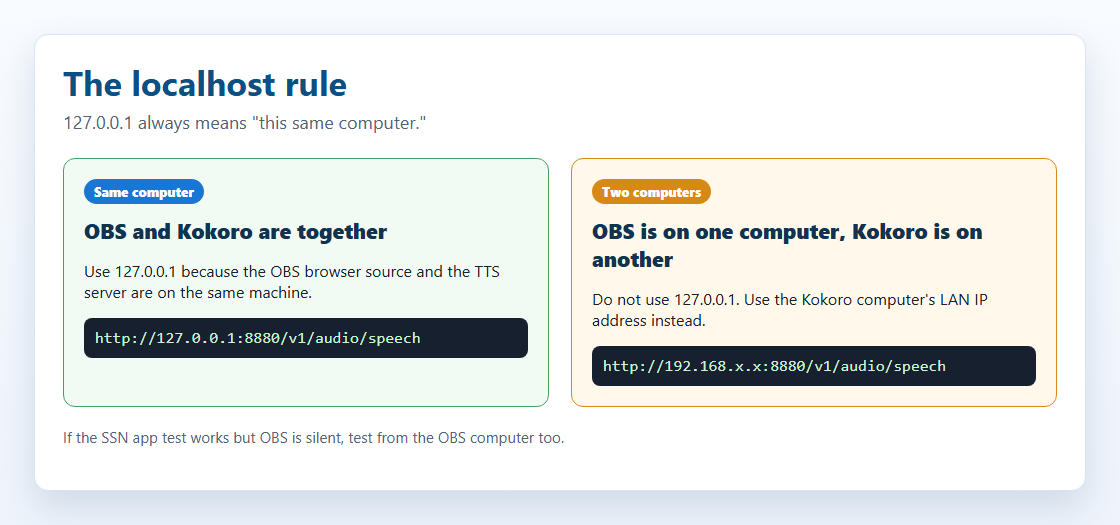
127.0.0.1 yalnızca TTS sunucusu sesi çalan sayfayla aynı bilgisayardaysa kullanın. Sunucu başka bir bilgisayardaysa o bilgisayarın yerel ağ IP adresini kullanın.| Kurulumunuz | Kullanılacak uç nokta |
|---|---|
| OBS ve Kokoro aynı bilgisayarda çalışıyor | http://127.0.0.1:8880/v1/audio/speech |
| Kokoro ev ağınızdaki başka bir bilgisayarda çalışıyor | http://192.168.x.x:8880/v1/audio/speech, Kokoro bilgisayarının yerel ağ IP adresini kullanarak |
| SSN masaüstü uygulamasının test düğmesi çalışıyor ancak OBS sessiz | OBS'nin yine de çalışan kendi uç noktasına ihtiyacı vardır. Uygulama testi, OBS'nin sunucuya erişebildiğini kanıtlamaz. |
Linux, macOS ve Windows'ta ayrıca güvenlik duvarının bağlantı noktasına izin verdiğini ve Docker'ın şu seçenekle bağlantı noktasını yayımladığını doğrulayın: -p 8880:8880.
SSN'de Nereye Tıklanır
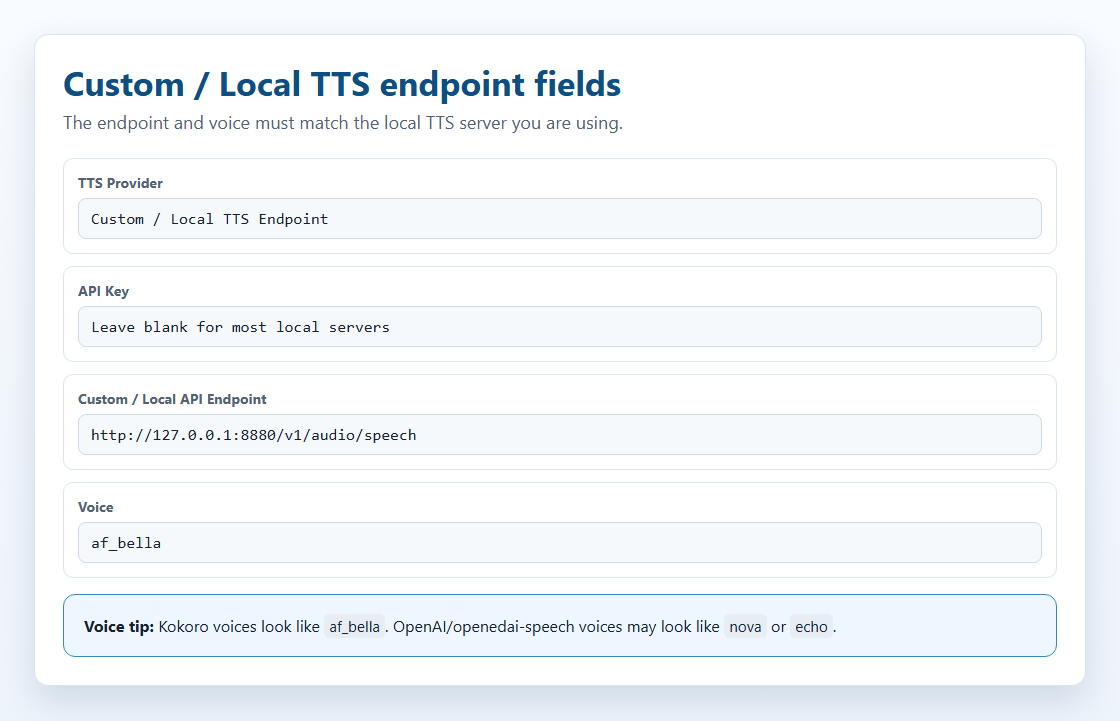
Eklenti açılır menüsünde TTS sağlayıcı seçicisini açın ve şunu seçin: Özel / Yerel TTS Uç Noktası. Bu, OpenAI uyumlu yerel uç nokta alanlarını ve bu kılavuza geri dönüş bağlantısını gösterir.
Kendi Barındırdığınız Sunucu Akışı
SSN yerel/kendi barındırdığınız TTS sunucusunu OpenAI uyumlu konuşma uç noktası olarak ele alır. Temel akış şöyledir:
İstek Biçimi
Şunun için: ttsprovider=customtts, localtts, veya openai, SSN yapılandırılmış uç noktaya bir JSON POST gönderir:
CORS, Barındırılan Sayfalar ve Köprü
CORS bir tarayıcı izin kontrolüdür. Basitçe: TTS sunucusu tarayıcıya “evet, bu sayfanın benden ses istemesine izin veriliyor” demelidir. Bu izin yoksa Kokoro veya başka bir TTS sunucusu isteği görmeden önce istek engellenebilir.
- Şunu yüklerseniz:
dock.htmlChrome veya OBS içinde kullanılıyorsa CORS önemli olabilir. - Şunun gibi barındırılan bir sayfa yüklerseniz:
https://beta.socialstream.ninja/dock.html, Chrome yerel veya özel HTTP adreslerine yapılan çağrıları da engelleyebilir. - SSN uygulamasındaki test düğmesi çalışıyor ama OBS Tarayıcı Kaynağı sessiz kalıyorsa OBS'yi ayrı test edin. OBS kendi tarayıcısını kullanır.
Sunucu tarayıcı isteklerine izin vermiyorsa şunu çalıştırın: SSN yerel TTS köprüsü ve SSN'yi şuraya yönlendirin: http://127.0.0.1:8124/v1/audio/speech. OBS için en kolay kurulum, köprüyü OBS ile aynı bilgisayarda çalıştırmaktır.
Desteklenen Ses Yanıtları
| Yanıt | SSN desteği | Notlar |
|---|---|---|
| İkili ses verisi | Evet | En iyi seçenek. Şunu döndürün: audio/mpeg, audio/wav, audio/ogg, audio/aac, veya tarayıcının oynatabildiği başka bir ses türü. |
| Ses URL'si içeren JSON | Evet | SSN şunu kontrol eder: url, audio_url, output_url, iç içe data.url, ve ilk data[] öğesi. |
| Base64 ses içeren JSON | Evet | SSN şunu kontrol eder: audio, audio_data, audioContent, b64_json, iç içe data alanlarını ve veri URL'lerini kontrol eder. |
| Ham PCM | Yalnızca sarmalayıcıyla | PCM'yi WAV dosyası veya base64 WAV olarak döndürün. Tarayıcının ses öğesi ham PCM baytlarını doğrudan güvenilir biçimde oynatamaz. |
mp3 küçük dosyalar ve geniş tarayıcı desteği için, wav yerel klonlama sunucuları ve köprü testleri için; ayrıca opus yalnızca hem sunucu hem tarayıcı destekliyorsa.
Akış Sesi
SSN şu anda özel/yerel TTS uç noktalarında aşamalı oynatma yapmaz. Yanıt blob'unu veya JSON ses yükünü bekler, ardından oynatır. Bazı üst sunucular akış uç noktaları sunsa da SSN'nin mevcut OpenAI uyumlu yolu oynatmadan önce arabelleğe alır.
Pratik sonuç: sohbet TTS parçalarını kısa tutun. Akış desteği için akış hâlindeki WAV/MP3 parçalarını, MediaSource'u, WebCodecs'i veya sunucu tarafı mikseri kullanan ayrı bir oynatma yolu gerekir.
Yol 1 — Yerleşik TTS (Kurulum Gerektirmez)
Bu motorlar Social Stream Ninja içinde paketlenmiştir ve kurulum gerektirmez. Tarayıcıda WebAssembly (WASM) veya ONNX Runtime kullanarak çalışırlar.
| Sağlayıcı | Kalite | CPU Kullanımı | GPU/WebGPU | URL parametresi |
|---|---|---|---|---|
| Kokoro TTS | ⭐⭐⭐⭐⭐ Mükemmel | Orta | GPU ile daha hızlı | ?ttsprovider=kokoro |
| Piper TTS | ⭐⭐⭐⭐ Çok İyi | Düşük | Yalnızca CPU | ?ttsprovider=piper |
| Kitten TTS | ⭐⭐⭐ İyi | Çok Düşük | Yalnızca CPU | ?ttsprovider=kitten |
| eSpeak-NG | ⭐⭐ Robotik | En az | Yalnızca CPU | ?ttsprovider=espeak |
Nasıl etkinleştirilir?
Ekleyin: &ttsprovider= ve &speech= Social Stream'inize: dock.html URL:
Kokoro TTS Seçenekleri
SSN şu anda 28 İngilizce, üç İspanyolca ve üç Brezilya Portekizcesi Kokoro sesi listeler. Birini belirtmek için şu parametreyi kullanın &voicekokoro=:
İspanyolca örnek:
Portekizce örnek:
Piper TTS Seçenekleri
Ses modelini şu parametreyle belirtin: &pipervoice=:
Portekizce ve İspanyolca Piper sesleri mevcuttur:
Kitten TTS Seçenekleri
eSpeak-NG Seçenekleri
Tarayıcı ve Masaüstü Uygulaması Notları
Chrome eklentisi, OBS tarayıcı kaynağı ve bağımsız Social Stream Ninja masaüstü uygulaması aynı parametreleri kullanır: dock.html sayfasının TTS URL parametreleri. Önemli fark, sesin nerede üretildiğidir.
| Arayüz | Yerel TTS davranışı | Ses yakalama |
|---|---|---|
| Chrome eklentisi / OBS tarayıcı kaynağı | SSN köprüsünü kullanmıyorsanız tarayıcı fetch isteği için yerel sunucuda CORS gerekir. | "Control audio via OBS" etkin OBS Tarayıcı Kaynağını kullanın. |
| Bağımsız masaüstü uygulaması | Aynı sağlayıcı ayarlarını kullanır. Uygulamanın yerel dosya pencereleri daha az CORS kısıtlamasına tabidir, ancak tarayıcı türü istekleri reddeden sunucular için köprü hâlâ en güvenli yoldur. | Masaüstü/uygulama sesini yakalayın veya uygulamayı sanal ses kablosuna yönlendirin. |
| Masaüstü uygulamasındaki yerleşik Kokoro | Uygulama yerel özelliğini kullanabilir: ninjafy.tts yolunu Kokoro için kullanabilir; böylece yalnızca tarayıcıda model yüklemeye bağlı kalmaz. |
Ses uygulamadan çalınır; bu nedenle masaüstü/uygulama sesi yakalamayı kullanın. |
dock.html URL'sini OBS'ye kopyalarsanız TTS sunucusuna erişip sesi çalması gereken OBS'dir.
Yol 2 — Kendi Barındırdığınız TTS Sunucusu
Daha fazla ses seçeneği, ses klonlama veya farklı araçlarda yeniden kullanabileceğiniz özel bir sunucu istiyorsanız yerel bir TTS sunucusu çalıştırabilirsiniz. Social Stream Ninja buna yerleşik özelliğiyle bağlanır: OpenAI uyumlu TTS uç noktası desteği — yerel sunucular için API anahtarı gerekmez.
Önerilen üç seçenek:
| Sunucu | Model | GPU | Disk | Varsayılan Bağlantı Noktası |
|---|---|---|---|---|
| Kokoro-FastAPI Önerilen | Kokoro 82M | İsteğe bağlı | ~2 GB | 8880 |
| openedai-speech (Piper) Hafif | Piper TTS | Yalnızca CPU | <1 GB | 8000 |
| kokoro-web | Kokoro 82M | İsteğe bağlı | ~2 GB | 3000 |
Hangi Paket Uygun?
| Paket | En önemli avantaj | Ödünleşim |
|---|---|---|
| Yerleşik Kokoro | İlk tercih için en iyisi: sunucu gerektirmez, kalitesi yüksektir, özeldir, tarayıcıda ve masaüstü uygulamasında çalışır. | Ses klonlama yok. |
| Kokoro-FastAPI | OpenAI uyumlu sunucu, kolay Docker kurulumu, CPU veya GPU, çok sayıda Kokoro sesi. | Gerçek ses klonlama yoktur; ses karıştırma ve özel ses özellikleri sunucu sürümüne bağlıdır. |
| openedai-speech | Hafif OpenAI uyumlu uç nokta; Piper CPU için uygundur ve XTTS yaklaşık 4 GB VRAM hedefiyle klonlama ekler. | Depoda büyük ölçüde eskidiği belirtilir; bu nedenle yararlı olsa da geleceğe dönük güvence sağlamadığını dikkate alın. |
| Chatterbox sunucuları | Ses klonlama, web arayüzü seçenekleri, OpenAI uyumlu API'ler, uzun metin araçları. | Bazı sürümlerde CUDA/GPU desteği CPU'dan daha sorunsuzdur; kurulum sunucu çatallamasına göre değişir. |
| GPT-SoVITS | Kısa referanslar ve döküm desteğiyle güçlü klonlama/kontrol. | Varsayılan olarak OpenAI uyumlu değildir; SSN köprü modunu kullanın. |
| F5-TTS | İstem WAV dosyası ve dökümüyle doğal zero-shot klonlama. | Resmî proje basit bir OpenAI uç noktası değildir; sarmalayıcı veya köprü modu kullanın. |
| Qwen3-TTS | Daha küçük 0.6B/1.7B modeller dahil modern klonlama ve ses tasarlama özellikleri. | Öncelikle kütüphane/demo sunar; SSN için sarmalayıcı gerekir. |
| MisoTTS | Üst düzey, istemle yönlendirilen konuşma üretimi. | 6 GB VRAM ile yerel kullanım hedefi değildir; gerekirse uzak/özel barındırma kullanın. |
Ses Klonlama Nasıl Çalışır
Ses klonlama ayrı bir SSN modu değildir. Bazı yerel TTS sunucularının içindeki bir özelliktir. SSN sohbet metnini yerel uç noktaya gönderir; sunucu klonlanan sesi kayıtlı bir referans ses dosyasından, ses profilinden veya köprü yapılandırmasından seçer.
Tipik Akış
- Genellikle tek bir kişinin 3 ile 30 saniyelik, az arka plan gürültüsü içeren temiz bir referans klibini kaydedin.
- Bazı motorlar ayrıca referans klibin tam dökümünü gerektirir.
- Yerel sunucu referansı konuşmacı istemine, gömmeye veya ses profiline dönüştürür.
- SSN canlı sohbet metnini uç noktaya şu yöntemle gönderir:
ttsprovider=customtts. - Sunucu, genellikle WAV veya MP3 biçiminde oynatılabilir bir ses dosyası döndürür; SSN bunu panelde/tarayıcı kaynağında oynatır.
6 GB veya daha az VRAM için önce küçük, örneksiz (zero-shot) klonlama modellerine ve OpenAI uyumlu sunuculara yönelin. Daha büyük modelleri başka bir yerde barındıran kullanıcılar da aynı SSN uç noktası üzerinden kullanabilir.
| Seçenek | Ses klonlama | 6 GB VRAM'e sığar | SSN için API yolu |
|---|---|---|---|
| Qwen3-TTS 0.6B Base | 3 saniyelik referans ses | Muhtemelen | OpenAI uyumlu sarmalayıcı kullanın, ardından ttsprovider=customtts |
| XTTS-v2 / openedai-speech | Kısa WAV referans sesleri | Evet, openedai-speech'e göre yaklaşık 4 GB | /v1/audio/speech |
| Chatterbox Turbo / Server | Referans sesle klonlama | Turbo / küçük parçalar kullanılıyorsa muhtemelen | OpenAI uyumlu sunucu sürümleri veya köprü |
| GPT-SoVITS | 5 saniyelik zero-shot, 1 dakikalık few-shot | fp16 / hafif kurulumla muhtemelen | Kullanın: scripts/local-tts-bridge.cjs --mode gptsovits |
| F5-TTS | İstem WAV dosyası + döküm | Belki; sürüme ve vocoder'a bağlı | OpenAI uyumlu bir sarmalayıcı veya şu seçeneği kullanın: --mode f5 F5-TTS sunucu sarmalayıcıları için |
| MisoTTS 8B | Ses istemi bağlamı | Hayır; proje 24 GB VRAM öneriyor | Yalnızca uzak/özel uç nokta |
POST /v1/audio/speech şununla: { model, input, voice, response_format, speed } ve oynatılabilir bir ses dosyası döndürür. Bu, OpenAI, Coqui/XTTS, Kokoro sarmalayıcıları, Qwen sarmalayıcıları ve çoğu vekil hizmeti kapsar.
Bilgisayar Gereksinimleri
Bunlar kesin garantiler değil, pratik başlangıç noktalarıdır. Model sürümü, nicemleme, metin uzunluğu, Docker imajı ve arka plan uygulamaları bellek kullanımını değiştirebilir.
| Seçenek | Pratik en düşük bilgisayar gereksinimi | İyi hedef | Notlar |
|---|---|---|---|
| Sistem TTS / eSpeak | Herhangi bir modern bilgisayar | Herhangi bir bilgisayar | Hızlı, düşük kaliteli, klonlama yok. |
| Yerleşik Kitten | Düşük güçlü CPU, 4 GB RAM | Modern dizüstü CPU'su, 8 GB RAM | Küçük ONNX modeli, hızlı başlatma. |
| Yerleşik Piper | Modern CPU, 4-8 GB RAM | Modern CPU, 8 GB RAM | Düşük kaynak tüketen iyi bir sinir ağı sesi seçeneği. |
| Yerleşik Kokoro | Modern CPU, 8 GB RAM | WebGPU destekli GPU veya hızlı CPU, 8-16 GB RAM | Kurulumsuz en iyi kalite. İlk yüklemede model varlıkları indirilir. |
| Kokoro-FastAPI | CPU Docker sunucusu, 8 GB RAM | NVIDIA GPU isteğe bağlı, 8-16 GB RAM | Tarayıcıda model yüklemek ideal olmadığında iyi bir yerel sunucu. |
| openedai-speech Piper | CPU, 4-8 GB RAM | CPU, 8 GB RAM | Hafif OpenAI uyumlu sunucu. |
| openedai-speech XTTS | Yaklaşık 4 GB VRAM'li NVIDIA GPU, 8-16 GB RAM | 6 GB+ NVIDIA GPU, 16 GB RAM | Ses klonlama yolu; CPU kullanılabilir ancak yavaştır. |
| Chatterbox sunucuları | Bazı sürümlerde CPU kullanılabilir ancak yavaştır | 6 GB+ NVIDIA GPU, 16 GB RAM | Klonlama yaparken veya uzun metin işlerken GPU kullanın. |
| GPT-SoVITS / F5-TTS / Qwen3-TTS | Yalnızca CPU testi, yavaş | Daha küçük/optimize edilmiş modeller için 6 GB+ NVIDIA GPU, 16 GB RAM | Sarmalayıcı seçimi ve model boyutu önemlidir. Daha fazla kurulum gerektireceğini hesaba katın. |
| MisoTTS 8B | 6 GB VRAM ile yerel kullanım önerilmez | 24 GB VRAM veya uzak sunucu | Depo, etkileşimli kullanım için yüksek VRAM'li GPU'lar önerir. |
Test Edilen Sunuculara İlişkin Notlar
Bunlar SSN uyumluluğu kontrol edilen, kendi barındırdığınız ses klonlama hedefleridir. Yerel uç nokta yolu şu ikisine karşı test edilmiştir: dock.html ve featured.html.
SSN doğrudan ikili ses yanıtlarını, base64 ses içeren JSON yanıtlarını ve ses URL'si içeren JSON yanıtlarını kabul eder. Mevcut özel/yerel oynatma, dönen sesi çalmadan önce arabelleğe alır; aşamalı akış oynatımı henüz desteklenmez.
| Sunucu | SSN yolu | Notlar |
|---|---|---|
| openedai-speech | Doğrudan veya köprü | OpenAI uyumlu /v1/audio/speech. Piper modu şu kaynaktan gerçek CPU senteziyle test edilmiştir: dock.html ve featured.html, doğrudan ve köprü üzerinden. Windows'ta kaynaktan çalıştırıyorsanız sanal ortamın Scripts klasörünün şurada bulunduğunu doğrulayın: PATH böylece piper.exe ve ffmpeg.exe bulunabilir olmalıdır. |
| chatterbox-tts-api | Doğrudan veya köprü | OpenAI uyumlu /v1/audio/speech. Klonlama için yapılandırılmış referans sesini kullanır. API biçimi doğrudan ve köprü üzerinden test edilmiştir. |
| Chatterbox-TTS-Server | Doğrudan veya köprü | OpenAI uyumlu uç nokta ve Web Arayüzü. Şununla gerçek CPU sentezi kullanılarak test edilmiştir: Emily.wav şuradan: dock.html ve featured.html, doğrudan ve köprü üzerinden. |
| GPT-SoVITS | Köprü modu | SSN köprüsünü şu seçenekle çalıştırın: --mode gptsovits; hedef sunucu: /tts, OpenAI uyumlu değildir. |
| F5-TTS_server | Köprü modu | SSN köprüsünü şu seçenekle çalıştırın: --mode f5; hedef sunucunun kullandığı: GET /synthesize_speech/. |
| Resmî F5-TTS | Sarmalayıcı gerekli | Öncelikle CLI, Gradio ve soket sunucusu kullanır. OpenAI uyumlu bir sarmalayıcı veya sarmalayıcıya bağlanan F5 köprü modunu kullanın. |
| Qwen3-TTS | Sarmalayıcı gerekli | Öncelikle kütüphane ve Gradio demosu sunar. Şunun etrafına küçük bir OpenAI uyumlu sarmalayıcı yazmak için iyi adaydır: generate_voice_clone. |
| MisoTTS | Yalnızca uzak/özel | Ses klonlama desteklenir, ancak 8B modeli 6 GB VRAM'e uygun değildir ve depoda yerel REST uç noktası bulunmaz. |
Kokoro-FastAPI Kurulumu
Kokoro-FastAPI Kokoro 82M modelini OpenAI uyumlu API'ye sahip yerel sunucu olarak çalıştırır. CPU'da çalışır (GPU gerekmez) ve mükemmel ses kalitesi sunar.
Docker ile Kurulum
Bir terminal açın (Komut İstemi, PowerShell veya Terminal) ve aşağıdakilerden birini çalıştırın:
CPU (her bilgisayarda çalışır):
GPU (yalnızca NVIDIA — daha hızlı sentez):
Çalıştığını Doğrulama
Tarayıcınızı açın ve şu adrese gidin: http://localhost:8880/web/— sesleri test edebileceğiniz bir web arayüzü görmelisiniz.
Kullanılabilir Sesler
67'den fazla ses mevcuttur. Öne çıkan bazıları:
Tüm seslere göz atın ve test edin: http://localhost:8880/web/ sunucu çalışmaya başladıktan sonra.
SSN URL'si
Kokoro-FastAPI, OBS ile aynı bilgisayardaysa:
Kokoro-FastAPI başka bir bilgisayardaysa şunu değiştirin: 192.168.x.x yerine o bilgisayarın yerel ağ IP adresini kullanın:
af_bella, af_sarah, am_adam, veya bf_emma. Şu gibi adlar: echo, nova, ve alloy OpenAI/openedai-speech tarzı adlardır ve Kokoro ile çalışmayabilir.
Sunucuyu Çalışır Tutma
Kokoro-FastAPI'nin arka planda otomatik çalışmasını sağlamak için Docker'ın yeniden başlatma bayrağını kullanın:
Artık her yeniden başlatmada Docker Desktop ile otomatik başlayacaktır.
openedai-speech Kurulumu (Piper ve XTTS-v2)
openedai-speech OpenAI uyumlu uç noktayı sunar: /v1/audio/speech uç noktasını sunar. Küçük imajı Piper'ı CPU üzerinde çalıştırır; tam imajı desteklenen GPU'da XTTS-v2 ses klonlamayı çalıştırabilir.
Seçenek A: Hafif Piper
1 GB'tan küçük, yalnızca CPU kullanan TTS sunucusu için bu seçeneği kullanın. XTTS-v2 veya ses klonlama içermez.
Docker Compose ile Kurulum
docker-compose.min.yml. Alternatif olarak aşağıdaki komutları doğrudan çalıştırın.
Windows'ta Kaynaktan Kurulum Notu
openedai-speech'i Docker yerine yerel bir kopyadan çalıştırıyorsanız sanal ortamının scripts klasörünü şuraya ekleyin: PATH sunucuyu başlatmadan önce. Aksi hâlde sunucu aşağıdakini bulamadığı için istekler HTTP 500 döndürebilir: piper.exe veya ffmpeg.exe.
Kullanılabilir Sesler
openedai-speech, Piper seslerine eşlenen OpenAI tarzı ses adlarını kullanır:
SSN URL'si
Seçenek B: XTTS-v2 Ses Klonlama
XTTS-v2 bir web API'si değil, modeldir. Modeli yüklemek, kayıtlı referans sesini seçmek, SSN'den sohbet metni almak ve oynatılabilir ses döndürmek için tam openedai-speech sunucusunu kullanın. Sunucu yaklaşık 4 GB GPU VRAM'i pratik hedef olarak bildirir; CPU üzerinde çıkarım mümkündür ancak yavaştır.
openedai-speech-min XTTS-v2 için. Minimal imaj yalnızca Piper içerir. XTTS-v2 için tam kurulum ve şu seçenek gerekir: model=tts-1-hd her konuşma isteğinde.
macOS veya Linux'ta şunu kullanın: cp sample.env speech.env — yerine kullanıldığı komut/değer: Copy-Item. Docker desteklenen bir GPU'ya erişebilmelidir. Model ilk kullanımda indirilir.
tts-1-hd bölümü; dosya: config/voice_to_speaker.yaml:Şunun altında zaten listelenmiş sesleri koruyun: tts-1-hd. Değiştirin: me değerini SSN'nin göndermesini istediğiniz ses adıyla değiştirin ve gerektiğinde doğru XTTS dil kodunu kullanın.
openaimodel=tts-1-hd XTTS-v2 için gereklidir. Bu belirtilmezse Social Stream varsayılan değerini gönderir: tts-1, openedai-speech bunun yerine Piper'ı seçer. voiceopenai değeri şuradaki klonlanmış ses adıyla eşleşmelidir: voice_to_speaker.yaml.
Tarayıcı veya OBS doğrudan isteği engelliyorsa şunu çalıştırın: Yerel TTS Köprüsü OBS bilgisayarında çalıştırın; şunu değiştirirken aynı model ve ses parametrelerini koruyun: openaiendpoint şu değere: http://127.0.0.1:8124/v1/audio/speech.
Yerel TTS Köprüsü
Köprü küçük bir yerel yardımcıdır. SSN'den gelen tarayıcı isteğini kabul eder, TTS sunucunuzla iletişim kurar, ardından sesi tarayıcıya uygun üstbilgilerle SSN'ye geri verir.
http://127.0.0.1:8124/v1/audio/speech, gerçek TTS sunucusu başka bir bilgisayarda olsa bile.

Bağımsız başlangıç klasörü: local-tts-bridge/; bkz. köprü README dosyası tüm başlatma seçenekleri için.
OpenAI Uyumlu Vekil
TTS sunucusu bu bilgisayardayken Windows PowerShell:
TTS sunucusu başka bir bilgisayardayken Windows PowerShell:
macOS/Linux terminali:
Ardından OBS'deki dock.html URL'sini köprüye yönlendirin:
GPT-SoVITS Vekil Modu
GPT-SoVITS kendi biçimini kullanır: /tts JSON biçimidir; köprü böylece SSN'nin OpenAI uyumlu isteğini GPT-SoVITS istek gövdesine çevirebilir.
F5-TTS Sunucu Vekil Modu
Bazı F5-TTS sunucu sarmalayıcıları şunu sunar: /synthesize_speech/?text=...&voice=... OpenAI uyumlu uç nokta yerine. Köprü SSN'nin isteğini bu sorgu biçimine dönüştürebilir.
http://127.0.0.1:8124/v1/audio/speech. Bağlantı noktasını şununla değiştirin: SSN_TTS_BRIDGE_PORT=8125 gerekirse.
Social Stream Ninja'ya Bağlanma
Yukarıdaki kendi barındırdığınız sunucuların tümü aynı bağlantı yöntemini kullanır — Social Stream'in yerleşik OpenAI TTS uç noktası desteğini özel bir yerel URL ile kullanır.
URL Parametreleri
| Parametre | Değer | Açıklama |
|---|---|---|
ttsprovider |
customtts veya openai |
OpenAI uyumlu TTS yolunu kullanın. Şunu kullanın: customtts yerel/kendi barındırdığınız uç noktalar için. |
openaiendpoint |
http://localhost:8880/v1/audio/speech |
Yerel sunucunuzun URL'si (gerektikçe bağlantı noktasını değiştirin) |
speech |
en-US |
İngilizce için TTS'yi etkinleştirir |
voiceopenai |
af_bella |
Ses adı (sunucuya bağlı) |
openaiformat |
mp3 |
Ses biçimi: mp3, wav, opus, flac |
openaispeed |
1.0 |
Konuşma hızı (0.5–2.0) |
customttsendpoint ve localttsendpoint de çalışır. customttsvoice, localttsvoice, customttsmodel, localttsmodel, customttsformat, ve localttsformat OpenAI tarzı alanlar için kabul edilen takma adlardır.
openaiendpoint TTS'yi oynatan sayfadan erişilebilir olmalıdır; ayrıca voiceopenai sunucunuzun desteklediği bir ses olmalıdır. Kokoro-FastAPI şu tür adlar kullanır: af_bella; openedai-speech genellikle şu tür adlar kullanır: nova veya echo.
Tam Örnek URL'ler
Kokoro-FastAPI:
openedai-speech:
kokoro-web:
Ek TTS Seçenekleri
Bunlar yerel sunucular dahil tüm TTS sağlayıcılarıyla çalışır:
| Parametre | Örnek | Açıklama |
|---|---|---|
simpletts |
&simpletts |
"Diyor" ifadesini atla — yalnızca mesajı oku |
simpletts2 |
&simpletts2 |
Kullanıcı adlarını tamamen atla |
volume |
&volume=0.8 |
Ses düzeyi (0.0–1.0) |
skipmessages |
&skipmessages=3 |
Yalnızca her 3. mesajı oku |
ttscommand |
&ttscommand=!say |
Yalnızca !say ile başlayan mesajları oku |
readevents |
&readevents |
Abonelikleri, bağışları vb. de oku. |
ttsquick |
&ttsquick=100 |
Bu karakter sayısından sonra konuşmayı bilerek keser. Mesajlar yarıda kesiliyorsa kaldırın. |
Desteklenmeye Değer Yerleşik Tarayıcı Seçenekleri
SSN hâlihazırda işletim sistemi/tarayıcı desteği sunar: speechSynthesis, yerleşik Kokoro, Piper, Kitten ve eSpeak. Gelecekte tarayıcı tarafında en yararlı eklemelerden biri, desteklendiği yerlerde ses çıkış aygıtı seçicisi olur: setSinkId kullanılabilir olduğunda; daha fazla Piper sesi seçeneği ve ses parçalarını akış hâlinde sunabilen sunucular için özel aşamalı oynatma yolu.
Sesi OBS'ye Aktarma
TTS sesini OBS'de nasıl yakalayacağınız, Social Stream Ninja'yı nasıl çalıştırdığınıza bağlıdır.
Yöntem 1 — OBS Tarayıcı Kaynağı Önerilen
En basit yöntem budur ve şunlarla çalışır: tüm TTS sağlayıcıları (yerleşik ve kendi barındırdığınız sunucu).
dock.html TTS parametrelerini içeren URLYöntem 2 — SSN Masaüstü Uygulaması + Masaüstü Sesi
Social Stream Ninja bağımsız masaüstü uygulamasını kullanıyorsanız (OBS tarayıcı kaynağı değil):
- Windows: VB-Audio Virtual Cable (ücretsiz)
- Şunu ayarlayın: CABLE Input seçeneğini Windows Ses ayarlarında SSN uygulamasının çıkışı olarak ayarlayın
- Yakalama CABLE Output OBS'de Ses Girişi Yakalama (Audio Input Capture) ile
Windows Ses Yönlendirme Bağlantıları
Windows 10 Uygulama Başına Yönlendirme
Windows 11 Uygulama Başına Yönlendirme
Audio Router Yazılımı
Audio Router tek bir uygulamayı sanal kabloya yönlendirebilir, ancak eski bir yazılımdır. Çalışıyorsa Windows'un uygulama başına yönlendirmesini tercih edin.
Voicemeeter Gelişmiş Yönlendirme
Voicemeeter TTS'yi yerel olarak duymak, OBS'ye yönlendirmek ve müzik/oyun sesinden ayrı tutmak istediğinizde en uygunudur.
?speech=en-US sağlayıcı olmadan kullanıldığında) tarayıcının sunduğu seslere bağlıdır. OBS hiç ses sunmayabilir veya sesleri listelediği hâlde yakalanabilir ses üretmeyebilir. Konuşmayı ve OBS kaydını ayrı ayrı test edin. Yukarıdaki sağlayıcılardan birini kullanın (kokoro, piper, vb.).
Karşılaştırma Tablosu
| Seçenek | Kurulum | Kalite | Özel | OBS (Tarayıcı Kaynağı) | GPU Gerekiyor | Maliyet |
|---|---|---|---|---|---|---|
| Yerleşik Kokoro | Yok | ⭐⭐⭐⭐⭐ | Evet | Evet | Hayır (GPU ile daha hızlı) | Ücretsiz |
| Yerleşik Piper | Yok | ⭐⭐⭐⭐ | Evet | Evet | Hayır | Ücretsiz |
| Yerleşik Kitten | Yok | ⭐⭐⭐ | Evet | Evet | Hayır | Ücretsiz |
| Yerleşik eSpeak | Yok | ⭐⭐ | Evet | Evet | Hayır | Ücretsiz |
| Kokoro-FastAPI | Docker | ⭐⭐⭐⭐⭐ | Evet | Evet | Hayır (isteğe bağlı) | Ücretsiz |
| openedai-speech | Docker | ⭐⭐⭐⭐ | Evet | Evet | Hayır | Ücretsiz |
| ElevenLabs | API Anahtarı | ⭐⭐⭐⭐⭐ | Hayır | Evet | Hayır | Ücretli planlar |
| Sistem TTS | Yok | ⭐⭐ | Evet | Hayır* | Hayır | Ücretsiz |
* Sistem TTS'nin OBS'de yakalanması için sanal ses kablosu yönlendirmesi gerekir.
Sorun giderme
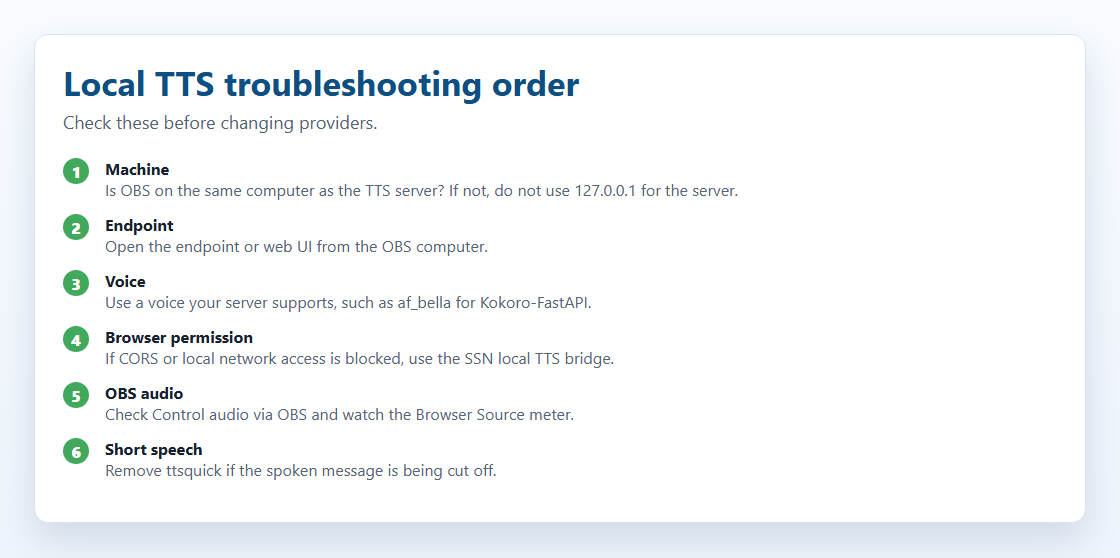
SSN uygulama testi çalışıyor ancak OBS'de ses yok
Uygulama testi yalnızca uygulamanın sunucuya erişebildiğini kanıtlar. OBS Tarayıcı Kaynağının yine de uç noktaya erişip sesi oynatması gerekir.
- OBS ve TTS sunucusu farklı bilgisayarlardaysa şunu değiştirin:
127.0.0.1yerine TTS sunucusu bilgisayarının yerel ağ IP adresini kullanın. - OBS Tarayıcı Kaynağında şunu doğrulayın: Sesi OBS üzerinden denetle işaretli olmalıdır.
- Tarayıcı isteği engelliyorsa OBS bilgisayarında SSN yerel TTS köprüsünü deneyin.
Yalnızca ilk harf veya ilk birkaç sözcük okunuyor
- Gerçekte kullanılan OBS URL'sinde şunu kontrol edin:
ttsquick. Bu seçenek, seslendirilen metni bilerek kısaltır. - Şunu görürseniz:
&ttsquick=14veya başka küçük bir sayı görürseniz kaldırın ve OBS Tarayıcı Kaynağını yenileyin. - Şunu kullanıyorsanız:
typewriter=, test sırasında geçici olarak kaldırın. TTS normalde özgün mesajı kullanır; ancak görsel efektleri kaldırmak zamanlama sorunlarını elemenin hızlı bir yoludur.
Yerel sunucu yanıt vermiyor
- Docker'ın çalıştığını ve konteynerin hâlâ başlatılmış olduğunu doğrulayın.
- TTS sunucusu bilgisayarında şunu açın:
http://127.0.0.1:8880/web/Kokoro-FastAPI içindir; kendi sunucunuzun uygun bağlantı noktasını da kullanabilirsiniz. - OBS bilgisayarından şunu açın:
http://SERVER_LAN_IP:8880/web/. Bu yüklenmiyorsa OBS de o sunucuyu kullanamaz. - Yerel ağ IP'si yüklenmiyorsa sunucu bilgisayarındaki güvenlik duvarını kontrol edin.
CORS veya yerel ağ engellendi
Tarayıcı isteğin CORS, yerel ağ erişimi, özel ağ erişimi veya failed fetch nedeniyle engellendiğini söylüyorsa TTS sunucusu isteği hiç almamış olabilir.
- Çalıştırın:
npm run local-tts-bridgeOBS bilgisayarında çalıştırın ve SSN'yi şuraya yönlendirin:http://127.0.0.1:8124/v1/audio/speech. - Barındırılan beta panel sayfasını kullanıyorsanız tarayıcının yerel HTTP uç noktalarını engelleme olasılığı daha yüksektir. Köprü veya yerel uygulama penceresi genellikle daha kolaydır.
Yanlış ses veya ses bulunamadı
- Kokoro-FastAPI: şunu deneyin:
af_bella,af_sarah,am_adam, veya Kokoro web arayüzünden başka bir ses. - openedai-speech: şu tür sesler:
nova,echo, vealloygeçerli olabilir. - Bazı sunucularda ses adları büyük/küçük harfe duyarlıdır.
Ses çalıyor ancak OBS yakalamıyor
- Şunu doğrulayın: Sesi OBS üzerinden denetle Tarayıcı Kaynağı özelliklerinde işaretli olmalıdır.
- Test mesajı çalarken OBS Ses Karıştırıcısını izleyin. Tarayıcı kaynağının göstergesi hareket etmelidir.
- Yalnızca sistem TTS kullanmadığınızdan emin olun (
?speech=en-US— kullanılmayan parametre:&ttsprovider=). Sistem TTS için masaüstü sesi veya sanal kabloyla yakalama gerekebilir.
Docker imajı bulunamadı
Docker imaj etiketleri değişebilir. Bu kılavuzdaki bir komut çalışmayı bırakırsa güncel etiket için proje sayfasını kontrol edin:
- Kokoro-FastAPI: github.com/remsky/Kokoro-FastAPI
- openedai-speech: github.com/matatonic/openedai-speech