概述
Social Stream Ninja可以使用本地AI文字转语音朗读聊天消息。“本地”有两种含义:语音在浏览器内运行,或者您在自己的电脑上运行小型文字转语音服务器。
有两种方式:
方式1 — 内置文字转语音 无需设置
多种高质量AI音色已 直接内置于Social Stream Ninja。它们通过WebAssembly或ONNX在浏览器中运行,无需服务器、Docker或安装。
- Kokoro 82M(最佳音质)
- Piper神经网络文字转语音
- Kitten TTS
- eSpeak-NG
只需添加URL参数即可使用。
方式2 — 自托管服务器 需要Docker
在电脑上运行本地文字转语音服务器,并让Social Stream Ninja连接到它。这样可获得更多音色、声音克隆和服务器端控制。
- Kokoro-FastAPI
- openedai-speech(Piper)
- kokoro-web
使用Social Stream内置的 OpenAI兼容端点 功能。
快速设置
对大多数主播来说,这是最简便的方式:
&speech=en-US&ttsprovider=kokoro 或 &speech=en-US&ttsprovider=kitten 到您的 dock.html URL。Testing local TTS。使用Kokoro或Piper时,请等待首次模型下载完成。localhost/127.0.0.1规则
这是最常见的本地文字转语音错误。
localhost 和 127.0.0.1 始终表示“当前这台电脑”。 如果OBS在一台电脑上,而Kokoro在另一台电脑上, 127.0.0.1 出现在OBS URL中时,指向的是OBS电脑,而不是Kokoro电脑。
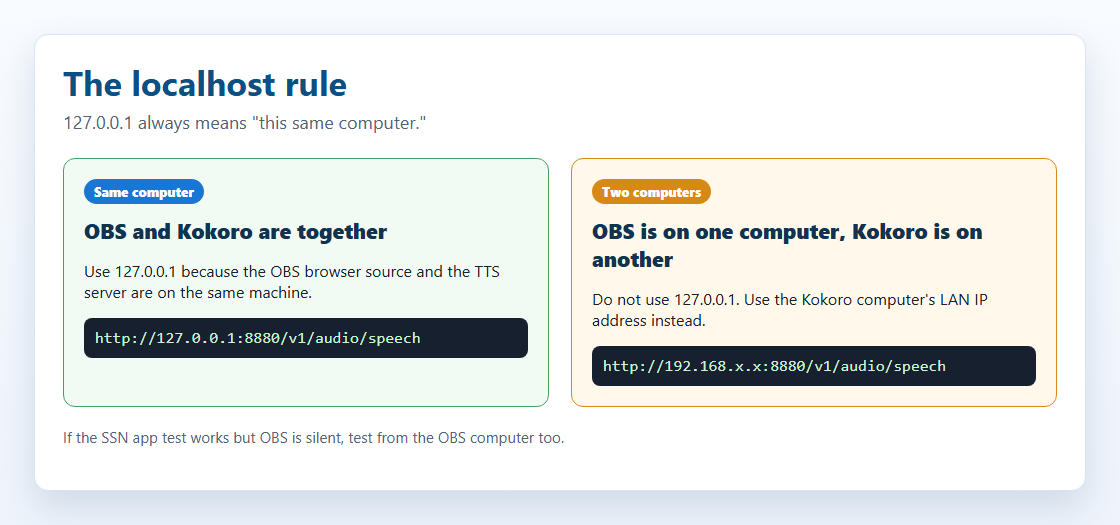
127.0.0.1 仅限文字转语音服务器与播放音频的页面位于同一台电脑。如果服务器在另一台电脑上,请使用那台电脑的局域网IP地址。| 您的配置 | 要使用的端点 |
|---|---|
| OBS和Kokoro在同一台电脑上运行 | http://127.0.0.1:8880/v1/audio/speech |
| Kokoro在家庭网络中的另一台电脑上运行 | http://192.168.x.x:8880/v1/audio/speech,使用运行Kokoro电脑的局域网IP |
| SSN桌面应用的测试按钮正常,但OBS没有声音 | OBS仍需要自己可用的端点。应用内测试成功,并不能证明OBS能够访问服务器。 |
在Linux、macOS和Windows上,还需确保防火墙允许该端口,并且Docker已通过以下选项发布端口: -p 8880:8880.
在SSN中点击哪里
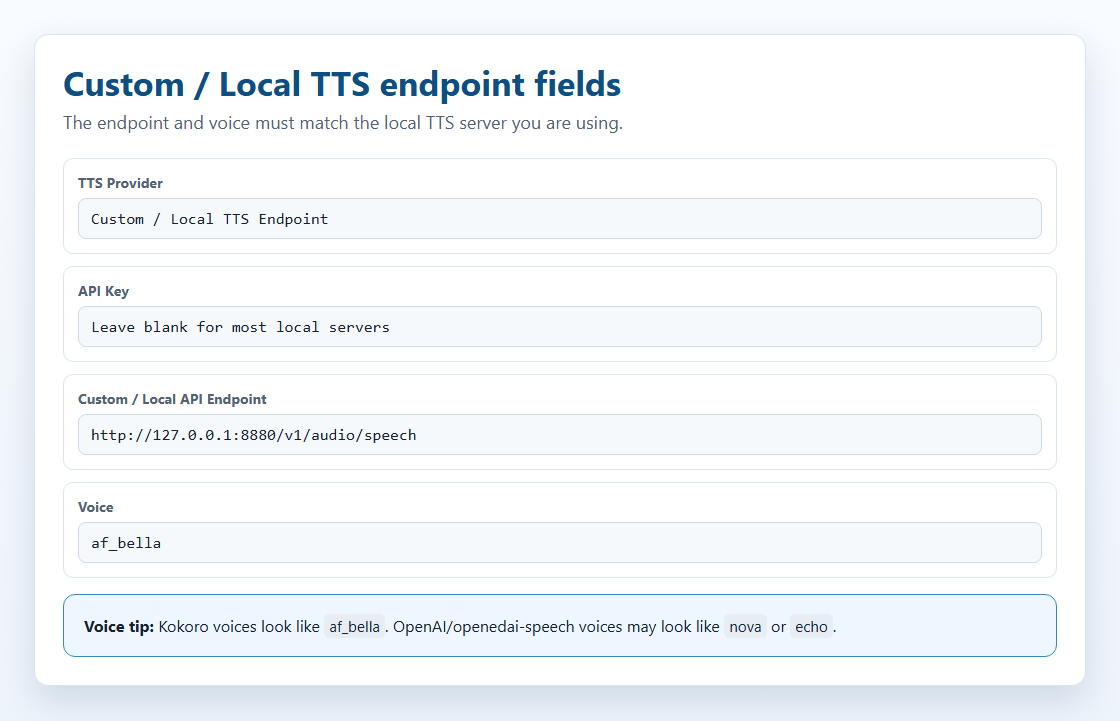
在扩展弹出菜单中,打开文字转语音提供商选择器并选择 自定义/本地文字转语音端点。这样会显示OpenAI兼容的本地端点字段,以及返回本指南的链接。
自托管流程
SSN将本地/自托管文字转语音服务器视为OpenAI兼容的语音端点。核心流程如下:
请求格式
对于 ttsprovider=customtts, localtts,或 openai,SSN会向配置的端点发送JSON POST请求:
CORS、托管页面与桥接服务
CORS是浏览器权限检查。简单来说,文字转语音服务器需要告诉浏览器:“可以,这个页面获准向我请求音频。”如果没有这个许可,请求可能在Kokoro或其他文字转语音服务器收到之前就被拦截。
- 如果加载
dock.html到Chrome或OBS中时,CORS可能会影响连接。 - 如果加载托管页面,例如
https://beta.socialstream.ninja/dock.html,Chrome也可能阻止对本地或私有HTTP地址的调用。 - 如果SSN应用内的测试按钮有效,但OBS浏览器源没有声音,请单独测试OBS。OBS有自己的浏览器环境。
如果服务器不允许浏览器请求,请运行 SSN本地文字转语音桥接服务 并将SSN指向 http://127.0.0.1:8124/v1/audio/speech。对于OBS,最简单的方式是在同一台电脑上运行桥接服务。
支持的音频响应
| 响应 | SSN支持情况 | 说明 |
|---|---|---|
| 二进制音频 | 是 | 最佳选择。返回 audio/mpeg, audio/wav, audio/ogg, audio/aac,或其他浏览器可播放的音频类型。 |
| 包含音频URL的JSON | 是 | SSN会检查 url, audio_url, output_url、嵌套的 data.url,以及第一个 data[] 条目。 |
| 包含base64音频的JSON | 是 | SSN会检查 audio, audio_data, audioContent, b64_json、嵌套的 data 字段,以及数据URL。 |
| 原始PCM | 仅在有封装时 | 将PCM作为WAV文件或base64 WAV返回。浏览器音频元素无法可靠地直接播放原始PCM字节。 |
mp3 适合小文件和广泛的浏览器支持, wav 用于本地克隆服务器和桥接测试,以及 opus 仅在服务器和浏览器都支持时。
流式音频
SSN目前不支持自定义/本地文字转语音端点的渐进式播放。它会等待响应blob或JSON音频负载,再进行播放。某些上游服务器提供流式端点,但SSN当前的OpenAI兼容路径会在播放前进行缓冲。
实际建议:保持聊天朗读片段简短。流式支持需要单独的播放路径,使用流式WAV/MP3片段、MediaSource、WebCodecs或服务器端混音器。
方式1 — 内置文字转语音(零设置)
这些引擎内置于Social Stream Ninja,无需安装。它们通过WebAssembly(WASM)或ONNX Runtime在浏览器中运行。
| 提供商 | 质量 | CPU使用情况 | GPU/WebGPU | URL 参数 |
|---|---|---|---|---|
| Kokoro TTS | ⭐⭐⭐⭐⭐ 出色 | 中等 | 使用GPU更快 | ?ttsprovider=kokoro |
| Piper TTS | ⭐⭐⭐⭐ 很好 | 低 | 仅CPU | ?ttsprovider=piper |
| Kitten TTS | ⭐⭐⭐ 良好 | 非常低 | 仅CPU | ?ttsprovider=kitten |
| eSpeak-NG | ⭐⭐ 机械感明显 | 极低 | 仅CPU | ?ttsprovider=espeak |
如何启用
添加 &ttsprovider= 和 &speech= 到您的Social Stream dock.html URL:
Kokoro文字转语音选项
SSN 目前列出 28 个英语、3 个西班牙语和 3 个巴西葡萄牙语 Kokoro 语音。使用以下参数指定一个语音: &voicekokoro=:
西班牙语示例:
葡萄牙语示例:
Piper文字转语音选项
通过以下参数指定音色模型: &pipervoice=:
提供葡萄牙语和西班牙语Piper音色:
Kitten文字转语音选项
eSpeak-NG选项
浏览器与桌面应用说明
Chrome扩展、OBS浏览器源和Social Stream Ninja独立桌面应用均使用相同的 dock.html 文字转语音URL参数。重要区别在于声音由哪里生成。
| 使用环境 | 本地文字转语音行为 | 音频捕获 |
|---|---|---|
| Chrome扩展/OBS浏览器源 | 除非使用SSN桥接服务,否则浏览器请求需要本地服务器提供CORS许可。 | 使用OBS浏览器源并开启“Control audio via OBS”。 |
| 独立桌面应用 | 使用相同的提供商设置。应用的本地文件窗口受到的CORS限制较少,但对于拒绝浏览器式请求的服务器,桥接服务仍是最稳妥的方式。 | 捕获桌面/应用音频,或将应用路由到虚拟音频线。 |
| 桌面应用中的内置Kokoro | 应用可以使用本地的 ninjafy.tts 路径用于Kokoro,而不是只依赖浏览器加载模型。 |
音频从应用播放,因此请使用桌面/应用音频捕获。 |
dock.html URL到OBS中,就需要由OBS访问文字转语音服务器并播放音频。
方式2 — 自托管文字转语音服务器
如果需要更多音色、声音克隆,或可供多种工具共用的专用服务器,可以运行本地文字转语音服务器。Social Stream Ninja通过其内置的以下功能连接: OpenAI兼容文字转语音端点 功能,本地服务器无需API密钥。
三个推荐选项:
| 服务器 | 模型 | GPU | 磁盘 | 默认端口 |
|---|---|---|---|---|
| Kokoro-FastAPI 推荐 | Kokoro 82M | 可选 | ~2 GB | 8880 |
| openedai-speech (Piper) 轻量 | Piper TTS | 仅CPU | <1 GB | 8000 |
| kokoro-web | Kokoro 82M | 可选 | ~2 GB | 3000 |
哪种软件包合适?
| 软件包 | 主要优点 | 取舍 |
|---|---|---|
| 内置Kokoro | 最佳首选:无需服务器、质量出色、保护隐私,并可在浏览器和桌面应用中使用。 | 不支持声音克隆。 |
| Kokoro-FastAPI | 兼容OpenAI的服务器,Docker设置简单,支持CPU或GPU,提供多种Kokoro音色。 | 没有真正的声音克隆;音色混合和自定义声音功能取决于服务器版本。 |
| openedai-speech | 轻量的OpenAI兼容端点;Piper适合CPU运行,XTTS则增加声音克隆,目标显存约4 GB。 | 仓库说明该项目大多已过时,因此可视为仍有用的工具,但不保证长期适用。 |
| Chatterbox服务器 | 声音克隆、网页界面选项、OpenAI兼容API和长文本工具。 | 某些版本的CUDA/GPU支持比CPU更顺畅;设置因服务器分支而异。 |
| GPT-SoVITS | 强大的克隆/控制功能,支持简短参考音频和转录文本。 | 默认不兼容OpenAI;请使用SSN桥接模式。 |
| F5-TTS | 通过提示WAV和转录文本,实现自然的零样本声音克隆。 | 官方项目不是简单的OpenAI端点;请使用封装或桥接模式。 |
| Qwen3-TTS | 现代声音克隆与声音设计功能,包括较小的0.6B/1.7B模型。 | 主要提供库/演示;需要封装才能用于SSN。 |
| MisoTTS | 高端提示式语音生成。 | 不适合6 GB显存的本地环境;如有需要,请使用远程或自定义托管。 |
声音克隆的工作原理
声音克隆不是单独的SSN模式,而是某些本地文字转语音服务器中的功能。SSN将聊天文本发送到本地端点,服务器再根据保存的参考音频文件、声音配置或桥接配置选择克隆音色。
典型流程
- 录制干净的参考片段,通常为3至30秒的单人说话,背景噪声应很少。
- 某些引擎还要求参考片段的准确转录文本。
- 本地服务器将参考录音转换为说话人提示、嵌入或声音配置。
- SSN通过以下方式将实时聊天文本发送到端点:
ttsprovider=customtts. - 服务器返回可播放的音频文件,通常为WAV或MP3,SSN再在停靠面板/浏览器源中播放。
显存为6 GB或更少时,优先选择小型零样本声音克隆模型和OpenAI兼容服务器。较大模型也可以通过同一个SSN端点使用,只要用户将其托管在其他地方。
| 选项 | 声音克隆 | 可在6 GB显存中运行 | SSN使用的API路径 |
|---|---|---|---|
| Qwen3-TTS 0.6B Base | 3秒参考音频 | 很可能可以 | 使用OpenAI兼容封装,然后 ttsprovider=customtts |
| XTTS-v2 / openedai-speech | 短WAV参考音色 | 是,openedai-speech报告约需4 GB | /v1/audio/speech |
| Chatterbox Turbo / Server | 参考音频克隆 | 使用Turbo或小片段时很可能可以 | OpenAI兼容服务器版本,或桥接服务的 |
| GPT-SoVITS | 5秒零样本,1分钟少样本 | 使用fp16或轻量安装时很可能可以 | 使用 scripts/local-tts-bridge.cjs --mode gptsovits |
| F5-TTS | 提示WAV+转录文本 | 可能可以;取决于版本和声码器 | 使用OpenAI兼容封装,或 --mode f5 用于F5-TTS服务器封装 |
| MisoTTS 8B | 提示音频上下文 | 不可以;项目建议24 GB显存 | 仅支持远程/自定义端点 |
POST /v1/audio/speech 带有 { model, input, voice, response_format, speed } 并返回可播放的音频文件。这样涵盖OpenAI、Coqui/XTTS、Kokoro封装、Qwen封装和大多数代理服务。
电脑要求
这些是实用的起点,而非硬性保证。模型版本、量化、文本长度、Docker镜像和后台应用都会影响内存使用。
| 选项 | 实用最低电脑配置 | 合适的目标 | 说明 |
|---|---|---|---|
| 系统文字转语音/eSpeak | 任何现代电脑 | 任何电脑 | 速度快,质量较低,不支持克隆。 |
| 内置Kitten | 低端CPU,4 GB内存 | 现代笔记本CPU,8 GB内存 | 小型ONNX模型,启动迅速。 |
| 内置Piper | 现代CPU,4–8 GB内存 | 现代CPU,8 GB内存 | 适合低资源环境的神经网络语音选项。 |
| 内置Kokoro | 现代CPU,8 GB内存 | 支持WebGPU的GPU或高速CPU,8–16 GB内存 | 无需设置即可获得最佳音质。首次加载会下载模型资源。 |
| Kokoro-FastAPI | CPU Docker主机,8 GB内存 | NVIDIA GPU可选,8–16 GB内存 | 浏览器模型加载不理想时,这是不错的本地服务器选择。 |
| openedai-speech Piper | CPU,4–8 GB内存 | CPU,8 GB内存 | 轻量的OpenAI兼容服务器。 |
| openedai-speech XTTS | 约4 GB显存的NVIDIA GPU,8–16 GB内存 | 6 GB以上显存的NVIDIA GPU,16 GB内存 | 声音克隆路径;可以使用CPU,但速度慢。 |
| Chatterbox服务器 | 某些版本可以使用CPU,但速度较慢 | 6 GB以上显存的NVIDIA GPU,16 GB内存 | 克隆声音或处理长文本时请使用GPU。 |
| GPT-SoVITS / F5-TTS / Qwen3-TTS | 仅用于CPU测试,速度慢 | 较小或优化的模型需要6 GB以上显存的NVIDIA GPU和16 GB内存 | 封装选择和模型大小很重要,预计需要更多设置。 |
| MisoTTS 8B | 不建议在6 GB显存环境中本地运行 | 24 GB显存或远程主机 | 仓库建议使用高显存GPU进行交互式使用。 |
已测试服务器说明
这些自托管声音克隆目标已检查过SSN兼容性。本地端点路径已针对以下两者进行测试: dock.html 和 featured.html.
SSN接受直接二进制音频响应、包含base64音频的JSON响应,以及包含音频URL的JSON响应。当前自定义/本地播放会先缓冲返回的音频再播放;尚不支持渐进式流式播放。
| 服务器 | SSN路径 | 说明 |
|---|---|---|
| openedai-speech | 直接连接或桥接 | 兼容OpenAI /v1/audio/speech。Piper模式已通过实际CPU语音合成测试,使用 dock.html 和 featured.html,包括直接连接和通过桥接连接。如果在Windows上从源码运行,请确保虚拟环境的 Scripts 文件夹位于 PATH 因此 piper.exe 和 ffmpeg.exe 可以被找到。 |
| chatterbox-tts-api | 直接连接或桥接 | 兼容OpenAI /v1/audio/speech。使用配置好的参考音频进行克隆。API格式已通过直接连接和桥接连接测试。 |
| Chatterbox-TTS-Server | 直接连接或桥接 | OpenAI兼容端点和网页界面。已使用以下音频进行实际CPU合成测试: Emily.wav 来自 dock.html 和 featured.html,包括直接连接和通过桥接连接。 |
| GPT-SoVITS | 桥接模式 | 运行SSN桥接服务,并使用 --mode gptsovits;目标服务器为 /tts,而非OpenAI兼容格式。 |
| F5-TTS_server | 桥接模式 | 运行SSN桥接服务,并使用 --mode f5;目标服务器使用 GET /synthesize_speech/. |
| F5-TTS官方项目 | 需要封装 | 主要提供CLI、Gradio和套接字服务器。请使用OpenAI兼容封装,或通过F5桥接模式连接封装服务。 |
| Qwen3-TTS | 需要封装 | 主要提供库和Gradio演示。适合围绕以下功能添加小型OpenAI兼容封装: generate_voice_clone. |
| MisoTTS | 仅远程/自定义 | 支持声音克隆,但8B模型不适合6 GB显存,且仓库中没有本地REST端点。 |
Kokoro-FastAPI设置
Kokoro-FastAPI 将Kokoro 82M模型作为本地服务器运行,提供OpenAI兼容API。它可使用CPU,无需GPU,并拥有出色的音质。
使用Docker安装
打开终端(命令提示符、PowerShell或Terminal),运行以下命令之一:
CPU(任何电脑均可使用):
GPU(仅NVIDIA,合成速度更快):
验证服务是否运行
打开浏览器并访问 http://localhost:8880/web/— 应看到可测试音色的网页界面。
可用音色
可用音色超过67种。部分示例:
在此浏览并测试所有音色: http://localhost:8880/web/ ,在服务器运行后。
SSN URL
如果Kokoro-FastAPI与OBS位于同一台电脑:
如果Kokoro-FastAPI在另一台电脑上,请替换 192.168.x.x 替换为那台电脑的局域网IP地址:
af_bella, af_sarah, am_adam,或 bf_emma。例如以下名称: echo, nova,以及 alloy 是OpenAI/openedai-speech风格的名称,可能无法用于Kokoro。
保持服务器运行
要让Kokoro-FastAPI在后台自动保持运行,请使用Docker的重启标志:
现在,每次重启时它都会随Docker Desktop自动启动。
openedai-speech设置(Piper和XTTS-v2)
openedai-speech 提供OpenAI兼容的 /v1/audio/speech 端点,正是Social Stream所需的格式。其小型镜像在CPU上运行Piper,完整镜像则可在支持的GPU上运行XTTS-v2声音克隆。
方案A:轻量级Piper
此选项适用于小于1 GB、仅使用CPU的文字转语音服务器,不包含XTTS-v2或声音克隆。
使用Docker Compose安装
docker-compose.min.yml。也可以直接运行以下命令。
Windows源码安装说明
如果从本地仓库而非Docker运行openedai-speech,请将其虚拟环境的脚本文件夹加入 PATH ,然后再启动服务器。否则,请求可能返回HTTP 500,因为服务器找不到 piper.exe 或 ffmpeg.exe.
可用音色
openedai-speech使用OpenAI风格的音色名称,并映射到Piper音色:
SSN URL
方案B:XTTS-v2声音克隆
XTTS-v2本身是模型,而不是Web API。请使用完整的openedai-speech服务器来加载模型、选择已保存的参考音色、接收SSN的聊天文本,并返回可播放的音频。服务器报告的实用目标约为4 GB GPU显存;CPU推理也可行,但速度慢。
openedai-speech-min 用于XTTS-v2。 精简镜像仅包含Piper。XTTS-v2需要完整安装及 model=tts-1-hd ,用于每次语音请求。
在macOS或Linux上使用 cp sample.env speech.env 而不是 Copy-Item。Docker必须能访问受支持的GPU。首次使用时会下载模型。
tts-1-hd 部分,位于 config/voice_to_speaker.yaml:保留已列在以下条目中的现有音色: tts-1-hd。更改 me 改为希望SSN发送的音色名称,并在需要时使用正确的XTTS语言代码。
openaimodel=tts-1-hd 是XTTS-v2所必需的。 如果省略,Social Stream会发送默认的 tts-1,openedai-speech会改用Piper。该 voiceopenai 值必须与以下配置中的克隆音色名称一致: voice_to_speaker.yaml.
如果浏览器或OBS阻止直接请求,请运行 本地文字转语音桥接服务 ,在OBS电脑上运行,更改以下值时保持模型和音色参数不变: openaiendpoint 为 http://127.0.0.1:8124/v1/audio/speech.
本地文字转语音桥接服务
桥接服务是一个小型本地辅助程序。它接收SSN的浏览器请求,与文字转语音服务器通信,再将音频连同适合浏览器的响应头返回给SSN。
http://127.0.0.1:8124/v1/audio/speech,即使实际的文字转语音服务器在另一台电脑上。

独立启动包文件夹为 local-tts-bridge/;请参阅 桥接服务README 以查看所有启动选项。
OpenAI兼容代理
Windows PowerShell,文字转语音服务器在同一台电脑时:
Windows PowerShell,文字转语音服务器在另一台电脑时:
macOS/Linux终端:
然后将OBS的 dock.html URL指向桥接服务:
GPT-SoVITS代理模式
GPT-SoVITS使用自己的 /tts JSON格式,因此桥接服务可以将SSN的OpenAI兼容请求转换为GPT-SoVITS请求体。
F5-TTS服务器代理模式
某些F5-TTS服务器封装提供 /synthesize_speech/?text=...&voice=... ,而不是OpenAI兼容端点。桥接服务可以将SSN请求转换为该查询格式。
http://127.0.0.1:8124/v1/audio/speech。通过以下选项更改端口: SSN_TTS_BRIDGE_PORT=8125 (如有需要)。
连接到Social Stream Ninja
以上所有自托管服务器都使用相同的连接方式,即Social Stream内置的 OpenAI文字转语音端点 功能,并使用自定义本地URL。
URL参数
| 参数 | 值 | 说明 |
|---|---|---|
ttsprovider |
customtts 或 openai |
使用OpenAI兼容的文字转语音路径。使用 customtts 用于本地/自托管端点。 |
openaiendpoint |
http://localhost:8880/v1/audio/speech |
本地服务器URL(按需更改端口) |
speech |
en-US |
启用英语文字转语音 |
voiceopenai |
af_bella |
音色名称(取决于服务器) |
openaiformat |
mp3 |
音频格式:mp3、wav、opus、flac |
openaispeed |
1.0 |
语速(0.5–2.0) |
customttsendpoint 和 localttsendpoint 也可以使用。 customttsvoice, localttsvoice, customttsmodel, localttsmodel, customttsformat,以及 localttsformat 是OpenAI风格字段接受的别名。
openaiendpoint 必须能从播放文字转语音的页面访问,并且 voiceopenai 必须是服务器支持的音色。Kokoro-FastAPI使用的名称例如 af_bella;openedai-speech常使用以下名称: nova 或 echo.
完整示例URL
Kokoro-FastAPI:
openedai-speech:
kokoro-web:
其他文字转语音选项
这些选项适用于任何文字转语音提供商,包括本地服务器:
| 参数 | 示例 | 说明 |
|---|---|---|
simpletts |
&simpletts |
跳过“说”字,只朗读消息 |
simpletts2 |
&simpletts2 |
完全跳过用户名 |
volume |
&volume=0.8 |
音量(0.0–1.0) |
skipmessages |
&skipmessages=3 |
每3条消息只朗读1条 |
ttscommand |
&ttscommand=!say |
仅朗读以!say开头的消息 |
readevents |
&readevents |
同时朗读订阅、打赏等 |
ttsquick |
&ttsquick=100 |
有意在指定字符数后截断语音。如果消息被截短,请移除此选项。 |
值得支持的内置浏览器选项
SSN已支持操作系统/浏览器的 speechSynthesis、内置Kokoro、Piper、Kitten和eSpeak。今后最实用的浏览器端改进是音频输出设备选择器,在以下条件下使用: setSinkId 可用时,以及更多Piper音色选项,并为能流式输出音频片段的服务器提供专用的渐进式流式播放路径。
将音频送入OBS
在OBS中捕获文字转语音音频的方法,取决于您如何运行Social Stream Ninja。
方法1 — OBS浏览器源 推荐
这是最简单的方法,适用于 所有文字转语音提供商 (内置和自托管服务器)。
dock.html 带文字转语音参数的URL方法2 — SSN桌面应用+桌面音频
如果使用Social Stream Ninja独立桌面应用,而不是OBS浏览器源:
- Windows: VB-Audio Virtual Cable (免费)
- 设置 CABLE Input 作为Windows声音设置中SSN应用的输出
- 捕获 CABLE Output ,在OBS中使用音频输入捕获
Windows音频路由链接
Windows 10按应用路由
Windows 11按应用路由
Audio Router软件
Audio Router 可以将单个应用路由到虚拟音频线,但这是较旧的软件。如果Windows按应用路由可用,请优先使用它。
Voicemeeter高级路由
Voicemeeter 最适合需要在本地听到文字转语音、将其送入OBS,并与音乐或游戏音频分开的情况。
?speech=en-US 且未指定提供商时)取决于浏览器提供的音色。 OBS可能不提供音色,也可能列出音色却无法生成可捕获的音频。请分别测试朗读和OBS录制。使用上方的某个提供商(kokoro, piper等)作为替代。
比较表
| 选项 | 设置 | 质量 | 私人 | OBS(浏览器源) | 需要GPU | 费用 |
|---|---|---|---|---|---|---|
| 内置Kokoro | 无 | ⭐⭐⭐⭐⭐ | 是 | 是 | 不需要(使用后更快) | 免费 |
| 内置Piper | 无 | ⭐⭐⭐⭐ | 是 | 是 | 否 | 免费 |
| 内置Kitten | 无 | ⭐⭐⭐ | 是 | 是 | 否 | 免费 |
| 内置eSpeak | 无 | ⭐⭐ | 是 | 是 | 否 | 免费 |
| Kokoro-FastAPI | Docker | ⭐⭐⭐⭐⭐ | 是 | 是 | 不需要(可选) | 免费 |
| openedai-speech | Docker | ⭐⭐⭐⭐ | 是 | 是 | 否 | 免费 |
| ElevenLabs | API密钥 | ⭐⭐⭐⭐⭐ | 否 | 是 | 否 | 付费方案 |
| 系统 TTS | 无 | ⭐⭐ | 是 | 否* | 否 | 免费 |
* 系统文字转语音需要通过虚拟音频线路由,才能由OBS捕获。
故障排除
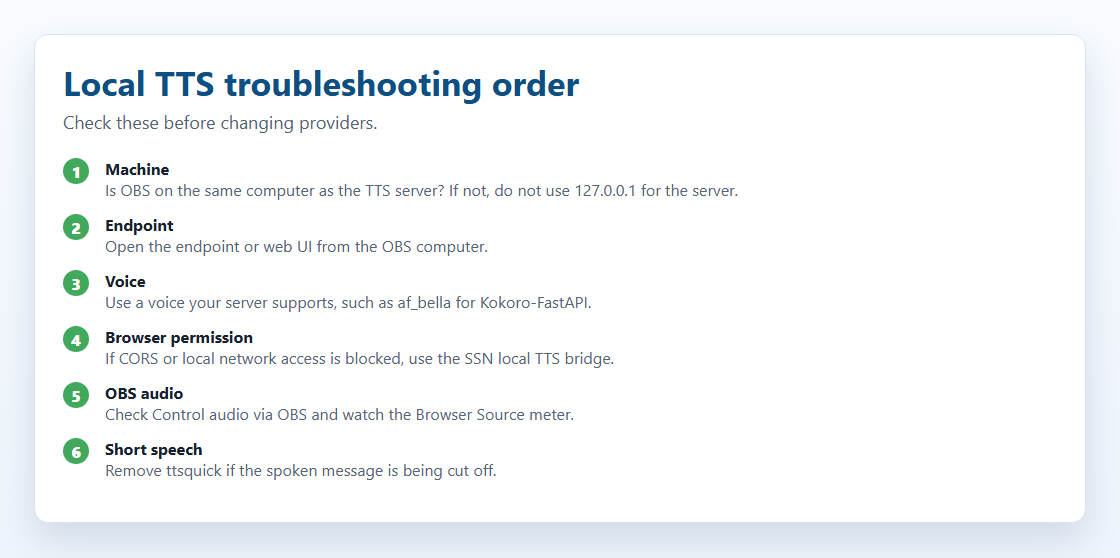
SSN应用内测试正常,但OBS没有声音
应用内测试只能证明应用能够访问服务器。OBS浏览器源仍需能够访问端点并播放音频。
- 如果OBS与文字转语音服务器位于不同电脑,请替换
127.0.0.1替换为文字转语音服务器电脑的局域网IP。 - 请确保OBS浏览器源已设置 通过 OBS 控制音频 已勾选。
- 如果浏览器阻止请求,请尝试在OBS电脑上运行SSN本地文字转语音桥接服务。
只朗读第一个字母或前几个词
- 检查OBS实际使用的URL是否包含
ttsquick。该选项会有意缩短朗读文本。 - 如果看到
&ttsquick=14或其他较小数值,请移除并刷新OBS浏览器源。 - 如果使用
typewriter=,请在测试时暂时移除。文字转语音通常使用原始消息,但移除视觉效果可快速排除时序问题。
本地服务器无响应
- 确认Docker正在运行,且容器仍处于启动状态。
- 在文字转语音服务器电脑上打开
http://127.0.0.1:8880/web/用于Kokoro-FastAPI,或使用服务器对应的端口。 - 在运行OBS的电脑上打开
http://SERVER_LAN_IP:8880/web/。如果无法加载,OBS也无法使用该服务器。 - 如果局域网IP无法加载,请检查服务器电脑的防火墙。
CORS或本地网络被阻止
如果浏览器提示请求被CORS、本地网络访问、私有网络访问或failed fetch阻止,文字转语音服务器可能根本没有收到请求。
- 运行
npm run local-tts-bridge,在OBS电脑上运行,并将SSN指向http://127.0.0.1:8124/v1/audio/speech. - 如果使用托管的beta停靠面板页面,本地HTTP端点更容易被浏览器阻止。使用桥接服务或本地应用窗口通常更简单。
音色错误或找不到音色
- Kokoro-FastAPI:尝试
af_bella,af_sarah,am_adam,或Kokoro网页界面中的其他音色。 - openedai-speech:音色例如
nova,echo,以及alloy可能有效。 - 某些服务器的音色名称区分大小写。
可以播放音频,但OBS未捕获
- 请确保 通过 OBS 控制音频 已在浏览器源属性中勾选。
- 播放测试消息时,观察OBS音频混音器。浏览器源的电平表应有变化。
- 请确保没有只使用系统文字转语音(
?speech=en-US不带&ttsprovider=)。系统文字转语音可能需要捕获桌面音频或使用虚拟音频线。
找不到Docker镜像
Docker镜像标签可能变化。如果本指南中的命令不再有效,请到项目页面查看当前标签:
- Kokoro-FastAPI: github.com/remsky/Kokoro-FastAPI
- openedai-speech: github.com/matatonic/openedai-speech