概述
Social Stream Ninja可以使用本機AI文字轉語音朗讀聊天訊息。「本機」有兩種含義:語音在瀏覽器內執行,或者您在自己的電腦上執行小型文字轉語音伺服器。
有兩種方式:
方式1 — 內建文字轉語音 不需設定
多種高品質AI聲音已 直接內建於Social Stream Ninja。它們透過WebAssembly或ONNX在瀏覽器中執行,不需伺服器、Docker或安裝。
- Kokoro 82M(最佳音質)
- Piper神經網路文字轉語音
- Kitten TTS
- eSpeak-NG
只要加入URL參數即可使用。
方式2 — 自行代管伺服器 需要Docker
在電腦上執行本機文字轉語音伺服器,並讓Social Stream Ninja連接到它。這樣可取得更多聲音、聲音複製和伺服器端控制。
- Kokoro-FastAPI
- openedai-speech(Piper)
- kokoro-web
使用Social Stream內建的 OpenAI相容端點 功能。
快速設定
對大多數實況主來說,這是最簡便的方式:
&speech=en-US&ttsprovider=kokoro 或 &speech=en-US&ttsprovider=kitten 到您的 dock.html URL。Testing local TTS。使用Kokoro或Piper時,請等待首次模型下載完成。localhost/127.0.0.1規則
這是最常見的本機文字轉語音錯誤。
localhost 和 127.0.0.1 永遠表示「目前這台電腦」。 如果OBS在一台電腦上,而Kokoro在另一台電腦上, 127.0.0.1 出現在OBS URL中時,指向的是OBS電腦,而不是Kokoro電腦。
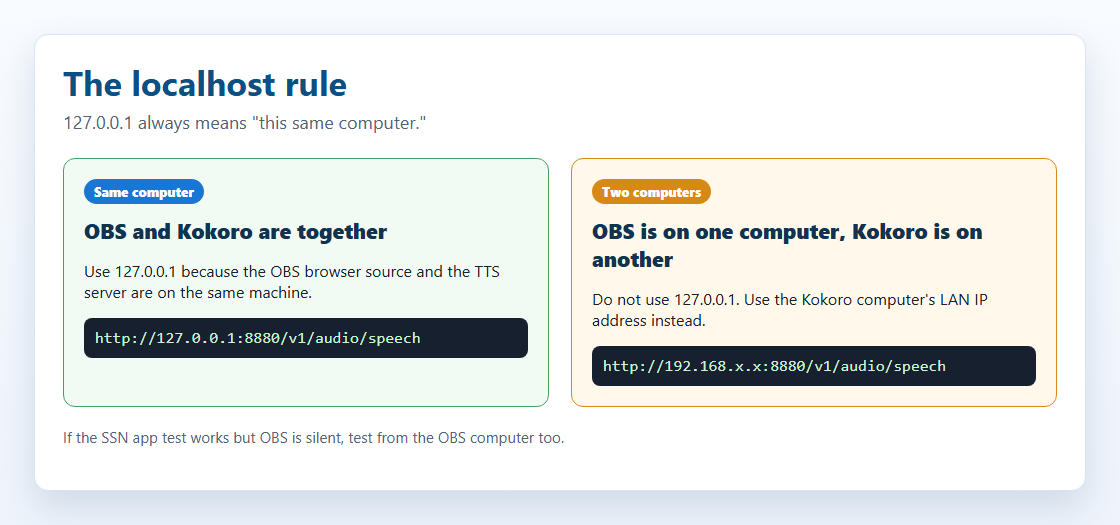
127.0.0.1 僅限文字轉語音伺服器與播放音訊的頁面位於同一台電腦。如果伺服器在另一台電腦上,請使用那台電腦的區域網路IP位址。| 您的設定 | 要使用的端點 |
|---|---|
| OBS和Kokoro在同一台電腦上執行 | http://127.0.0.1:8880/v1/audio/speech |
| Kokoro在家用網路中的另一台電腦上執行 | http://192.168.x.x:8880/v1/audio/speech,使用執行Kokoro電腦的區域網路IP |
| SSN桌面應用程式的測試按鈕正常,但OBS沒有聲音 | OBS仍需要自己可用的端點。應用程式內測試成功,並不能證明OBS能夠存取伺服器。 |
在Linux、macOS和Windows上,還需確認防火牆允許該連接埠,而且Docker已透過以下選項發佈連接埠: -p 8880:8880.
在SSN中點選哪裡
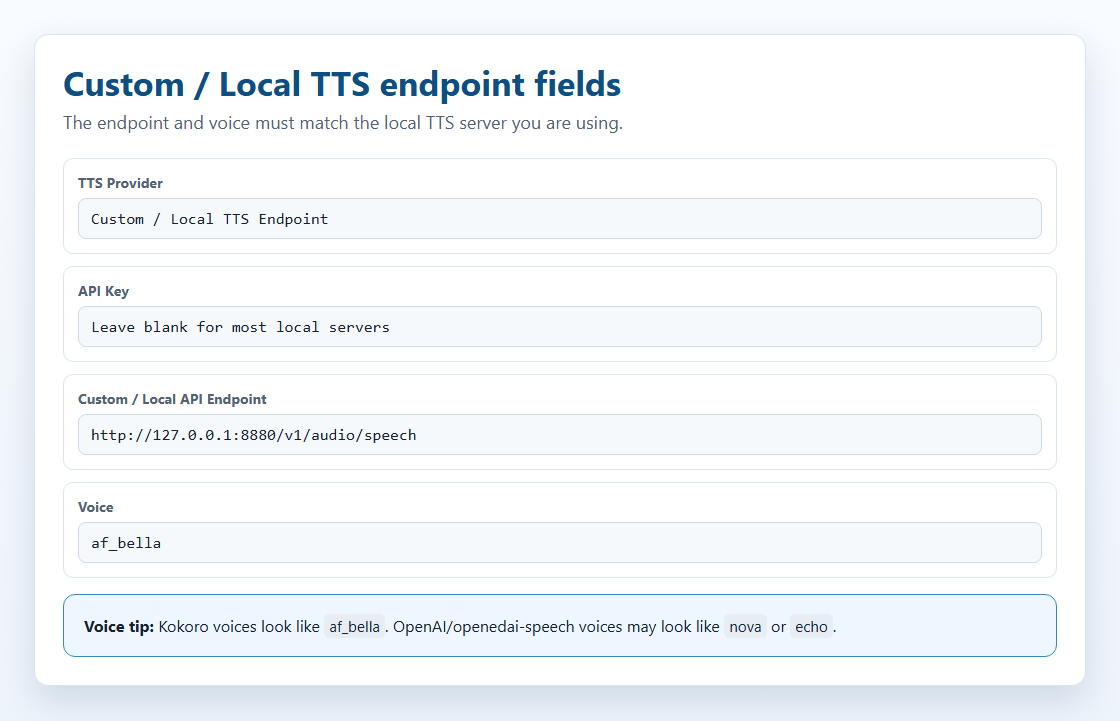
在擴充功能彈出選單中,開啟文字轉語音提供者選擇器並選擇 自訂/本機文字轉語音端點。這樣會顯示OpenAI相容的本機端點欄位,以及返回本指南的連結。
自行代管流程
SSN將本機/自行代管文字轉語音伺服器視為OpenAI相容的語音端點。核心流程如下:
請求格式
對於 ttsprovider=customtts, localtts,或 openai,SSN會向設定的端點傳送JSON POST請求:
CORS、代管頁面與橋接服務
CORS是瀏覽器權限檢查。簡單來說,文字轉語音伺服器需要告訴瀏覽器:「可以,這個頁面獲准向我請求音訊。」如果沒有這個許可,請求可能在Kokoro或其他文字轉語音伺服器收到之前就被攔截。
- 如果載入
dock.html到Chrome或OBS中時,CORS可能會影響連線。 - 如果載入代管頁面,例如
https://beta.socialstream.ninja/dock.html,Chrome也可能阻止對本機或私人HTTP位址的呼叫。 - 如果SSN應用程式內的測試按鈕有效,但OBS瀏覽器來源沒有聲音,請單獨測試OBS。OBS有自己的瀏覽器環境。
如果伺服器不允許瀏覽器請求,請執行 SSN本機文字轉語音橋接服務 並將SSN指向 http://127.0.0.1:8124/v1/audio/speech。對於OBS,最簡單的方式是在同一台電腦上執行橋接服務。
支援的音訊回應
| 回應 | SSN支援情況 | 說明 |
|---|---|---|
| 二進位音訊 | 是 | 最佳選擇。回傳 audio/mpeg, audio/wav, audio/ogg, audio/aac,或其他瀏覽器可播放的音訊類型。 |
| 包含音訊URL的JSON | 是 | SSN會檢查 url, audio_url, output_url、巢狀的 data.url,以及第一個 data[] 項目。 |
| 包含base64音訊的JSON | 是 | SSN會檢查 audio, audio_data, audioContent, b64_json、巢狀的 data 欄位,以及資料URL。 |
| 原始PCM | 僅在有封裝時 | 將PCM作為WAV檔案或base64 WAV回傳。瀏覽器音訊元素無法可靠地直接播放原始PCM位元組。 |
mp3 適合小檔案和廣泛的瀏覽器支援, wav 用於本機複製聲音伺服器和橋接測試,以及 opus 僅在伺服器和瀏覽器都支援時。
串流音訊
SSN目前不支援自訂/本機文字轉語音端點的漸進式播放。它會等待回應blob或JSON音訊酬載,再進行播放。某些上游伺服器提供串流端點,但SSN目前的OpenAI相容路徑會在播放前進行緩衝。
實際建議:保持聊天朗讀片段簡短。串流支援需要獨立的播放路徑,使用串流WAV/MP3片段、MediaSource、WebCodecs或伺服器端混音器。
方式1 — 內建文字轉語音(零設定)
這些引擎內建於Social Stream Ninja,不需安裝。它們透過WebAssembly(WASM)或ONNX Runtime在瀏覽器中執行。
| 提供者 | 品質 | CPU使用情況 | GPU/WebGPU | URL 參數 |
|---|---|---|---|---|
| Kokoro TTS | ⭐⭐⭐⭐⭐ 出色 | 中等 | 使用GPU更快 | ?ttsprovider=kokoro |
| Piper TTS | ⭐⭐⭐⭐ 很好 | 低 | 僅CPU | ?ttsprovider=piper |
| Kitten TTS | ⭐⭐⭐ 良好 | 非常低 | 僅CPU | ?ttsprovider=kitten |
| eSpeak-NG | ⭐⭐ 機械感明顯 | 極低 | 僅CPU | ?ttsprovider=espeak |
如何啟用
新增 &ttsprovider= 和 &speech= 到您的Social Stream dock.html URL:
Kokoro文字轉語音選項
SSN 目前列出 28 個英語、3 個西班牙語和 3 個巴西葡萄牙語 Kokoro 語音。使用以下參數指定一個語音: &voicekokoro=:
西班牙語範例:
葡萄牙語範例:
Piper文字轉語音選項
透過以下參數指定聲音模型: &pipervoice=:
提供葡萄牙語和西班牙語Piper聲音:
Kitten文字轉語音選項
eSpeak-NG選項
瀏覽器與桌面應用程式說明
Chrome擴充功能、OBS瀏覽器來源和Social Stream Ninja獨立桌面應用程式皆使用相同的 dock.html 文字轉語音URL參數。重要差別在於聲音由哪裡產生。
| 使用環境 | 本機文字轉語音行為 | 音訊擷取 |
|---|---|---|
| Chrome擴充功能/OBS瀏覽器來源 | 除非使用SSN橋接服務,否則瀏覽器請求需要本機伺服器提供CORS許可。 | 使用OBS瀏覽器來源並開啟「Control audio via OBS」。 |
| 獨立桌面應用程式 | 使用相同的提供者設定。應用程式的本機檔案視窗受到的CORS限制較少,但對於拒絕瀏覽器式請求的伺服器,橋接服務仍是最穩妥的方式。 | 擷取桌面/應用程式音訊,或將應用程式路由到虛擬音訊線。 |
| 桌面應用程式中的內建Kokoro | 應用程式可以使用本機的 ninjafy.tts 路徑用於Kokoro,而不是只依賴瀏覽器載入模型。 |
音訊從應用程式播放,因此請使用桌面/應用程式音訊擷取。 |
dock.html URL到OBS中,就需要由OBS存取文字轉語音伺服器並播放音訊。
方式2 — 自行代管文字轉語音伺服器
如果需要更多聲音、聲音複製,或可供多種工具共用的專用伺服器,可以執行本機文字轉語音伺服器。Social Stream Ninja透過其內建的以下功能連接: OpenAI相容文字轉語音端點 功能,本機伺服器不需API金鑰。
三個建議選項:
| 伺服器 | 模型 | GPU | 磁碟 | 預設連接埠 |
|---|---|---|---|---|
| Kokoro-FastAPI 建議 | Kokoro 82M | 選用 | ~2 GB | 8880 |
| openedai-speech (Piper) 輕量 | Piper TTS | 僅CPU | <1 GB | 8000 |
| kokoro-web | Kokoro 82M | 選用 | ~2 GB | 3000 |
哪種套件合適?
| 套件 | 主要優點 | 取捨 |
|---|---|---|
| 內建Kokoro | 最佳首選:不需伺服器、品質出色、保護隱私,並可在瀏覽器和桌面應用程式中使用。 | 不支援聲音複製。 |
| Kokoro-FastAPI | 相容OpenAI的伺服器,Docker設定簡單,支援CPU或GPU,提供多種Kokoro聲音。 | 沒有真正的聲音複製;聲音混合和自訂聲音功能取決於伺服器版本。 |
| openedai-speech | 輕量的OpenAI相容端點;Piper適合CPU執行,XTTS則增加聲音複製,目標顯示記憶體約4 GB。 | 儲存庫說明該專案大多已過時,因此可視為仍有用的工具,但不保證長期適用。 |
| Chatterbox伺服器 | 聲音複製、網頁介面選項、OpenAI相容API和長文字工具。 | 某些版本的CUDA/GPU支援比CPU更順暢;設定因伺服器分支而異。 |
| GPT-SoVITS | 強大的複製/控制功能,支援簡短參考音訊和轉錄文字。 | 預設不相容OpenAI;請使用SSN橋接模式。 |
| F5-TTS | 透過提示WAV和轉錄文字,實現自然的零樣本聲音複製。 | 官方專案不是簡單的OpenAI端點;請使用封裝或橋接模式。 |
| Qwen3-TTS | 現代聲音複製與聲音設計功能,包括較小的0.6B/1.7B模型。 | 主要提供程式庫/示範;需要封裝才能用於SSN。 |
| MisoTTS | 高階提示式語音生成。 | 不適合6 GB顯示記憶體的本機環境;如有需要,請使用遠端或自訂代管。 |
聲音複製的運作原理
聲音複製不是獨立的SSN模式,而是某些本機文字轉語音伺服器中的功能。SSN將聊天文字傳送到本機端點,伺服器再根據儲存的參考音訊檔案、聲音設定檔或橋接設定選擇複製聲音。
典型流程
- 錄製乾淨的參考片段,通常為3至30秒的單人說話,背景雜音應很少。
- 某些引擎也要求參考片段的正確轉錄文字。
- 本機伺服器將參考錄音轉換為說話者提示、嵌入或聲音設定檔。
- SSN透過以下方式將即時聊天文字傳送到端點:
ttsprovider=customtts. - 伺服器回傳可播放的音訊檔案,通常為WAV或MP3,SSN再在停駐面板/瀏覽器來源中播放。
顯示記憶體為6 GB或更少時,優先選擇小型零樣本聲音複製模型和OpenAI相容伺服器。較大模型也可以透過同一個SSN端點使用,只要使用者將其代管在其他地方。
| 選項 | 聲音複製 | 可在6 GB顯示記憶體中執行 | SSN使用的API路徑 |
|---|---|---|---|
| Qwen3-TTS 0.6B Base | 3秒參考音訊 | 很可能可以 | 使用OpenAI相容封裝,然後 ttsprovider=customtts |
| XTTS-v2 / openedai-speech | 短WAV參考聲音 | 是,openedai-speech報告約需4 GB | /v1/audio/speech |
| Chatterbox Turbo / Server | 參考音訊複製 | 使用Turbo或小片段時很可能可以 | OpenAI相容伺服器版本,或橋接服務的 |
| GPT-SoVITS | 5秒零樣本,1分鐘少樣本 | 使用fp16或輕量安裝時很可能可以 | 使用 scripts/local-tts-bridge.cjs --mode gptsovits |
| F5-TTS | 提示WAV+轉錄文字 | 可能可以;取決於版本和聲碼器 | 使用OpenAI相容封裝,或 --mode f5 用於F5-TTS伺服器封裝 |
| MisoTTS 8B | 提示音訊脈絡 | 不可以;專案建議24 GB顯示記憶體 | 僅支援遠端/自訂端點 |
POST /v1/audio/speech 帶有 { model, input, voice, response_format, speed } 並回傳可播放的音訊檔案。這樣涵蓋OpenAI、Coqui/XTTS、Kokoro封裝、Qwen封裝和大多數代理服務。
電腦需求
這些是實用的起點,而非硬性保證。模型版本、量化、文字長度、Docker映像檔和背景應用程式都會影響記憶體使用。
| 選項 | 實用最低電腦規格 | 合適的目標 | 說明 |
|---|---|---|---|
| 系統文字轉語音/eSpeak | 任何現代電腦 | 任何電腦 | 速度快,品質較低,不支援複製聲音。 |
| 內建Kitten | 低階CPU,4 GB記憶體 | 現代筆記型電腦CPU,8 GB記憶體 | 小型ONNX模型,啟動迅速。 |
| 內建Piper | 現代CPU,4–8 GB記憶體 | 現代CPU,8 GB記憶體 | 適合低資源環境的神經網路語音選項。 |
| 內建Kokoro | 現代CPU,8 GB記憶體 | 支援WebGPU的GPU或高速CPU,8–16 GB記憶體 | 不需設定即可獲得最佳音質。首次載入會下載模型資源。 |
| Kokoro-FastAPI | CPU Docker主機,8 GB記憶體 | NVIDIA GPU選用,8–16 GB記憶體 | 瀏覽器模型載入不理想時,這是不錯的本機伺服器選擇。 |
| openedai-speech Piper | CPU,4–8 GB記憶體 | CPU,8 GB記憶體 | 輕量的OpenAI相容伺服器。 |
| openedai-speech XTTS | 約4 GB顯示記憶體的NVIDIA GPU,8–16 GB記憶體 | 6 GB以上顯示記憶體的NVIDIA GPU,16 GB記憶體 | 聲音複製路徑;可以使用CPU,但速度慢。 |
| Chatterbox伺服器 | 某些版本可以使用CPU,但速度較慢 | 6 GB以上顯示記憶體的NVIDIA GPU,16 GB記憶體 | 複製聲音或處理長文字時請使用GPU。 |
| GPT-SoVITS / F5-TTS / Qwen3-TTS | 僅用於CPU測試,速度慢 | 較小或最佳化的模型需要6 GB以上顯示記憶體的NVIDIA GPU和16 GB記憶體 | 封裝選擇和模型大小很重要,預期需要更多設定。 |
| MisoTTS 8B | 不建議在6 GB顯示記憶體環境中本機執行 | 24 GB顯示記憶體或遠端主機 | 儲存庫建議使用高顯示記憶體GPU進行互動式使用。 |
已測試伺服器說明
這些自行代管聲音複製目標已檢查過SSN相容性。本機端點路徑已針對以下兩者進行測試: dock.html 和 featured.html.
SSN接受直接二進位音訊回應、包含base64音訊的JSON回應,以及包含音訊URL的JSON回應。目前自訂/本機播放會先緩衝回傳的音訊再播放;尚不支援漸進式串流播放。
| 伺服器 | SSN路徑 | 說明 |
|---|---|---|
| openedai-speech | 直接連線或橋接 | 相容OpenAI /v1/audio/speech。Piper模式已通過實際CPU語音合成測試,使用 dock.html 和 featured.html,包括直接連線和透過橋接連線。如果在Windows上從原始碼執行,請確認虛擬環境的 Scripts 資料夾位於 PATH 因此 piper.exe 和 ffmpeg.exe 可以被找到。 |
| chatterbox-tts-api | 直接連線或橋接 | 相容OpenAI /v1/audio/speech。使用設定好的參考音訊進行複製。API格式已通過直接連線和橋接連線測試。 |
| Chatterbox-TTS-Server | 直接連線或橋接 | OpenAI相容端點和網頁介面。已使用以下音訊進行實際CPU合成測試: Emily.wav 來自 dock.html 和 featured.html,包括直接連線和透過橋接連線。 |
| GPT-SoVITS | 橋接模式 | 執行SSN橋接服務,並使用 --mode gptsovits;目標伺服器為 /tts,而非OpenAI相容格式。 |
| F5-TTS_server | 橋接模式 | 執行SSN橋接服務,並使用 --mode f5;目標伺服器使用 GET /synthesize_speech/. |
| F5-TTS官方專案 | 需要封裝 | 主要提供CLI、Gradio和通訊端伺服器。請使用OpenAI相容封裝,或透過F5橋接模式連接封裝服務。 |
| Qwen3-TTS | 需要封裝 | 主要提供程式庫和Gradio示範。適合圍繞以下功能加入小型OpenAI相容封裝: generate_voice_clone. |
| MisoTTS | 僅遠端/自訂 | 支援聲音複製,但8B模型不適合6 GB顯示記憶體,而且儲存庫中沒有本機REST端點。 |
Kokoro-FastAPI設定
Kokoro-FastAPI 將Kokoro 82M模型作為本機伺服器執行,提供OpenAI相容API。它可使用CPU,不需GPU,並擁有出色的音質。
使用Docker安裝
開啟終端機(命令提示字元、PowerShell或Terminal),執行以下指令之一:
CPU(任何電腦皆可使用):
GPU(僅NVIDIA,合成速度更快):
驗證服務是否執行
開啟瀏覽器並前往 http://localhost:8880/web/— 應看到可測試聲音的網頁介面。
可用聲音
可用聲音超過67種。部分範例:
在此瀏覽並測試所有聲音: http://localhost:8880/web/ ,在伺服器執行後。
SSN URL
如果Kokoro-FastAPI與OBS位於同一台電腦:
如果Kokoro-FastAPI在另一台電腦上,請替換 192.168.x.x 替換為那台電腦的區域網路IP位址:
af_bella, af_sarah, am_adam,或 bf_emma。例如以下名稱: echo, nova,以及 alloy 是OpenAI/openedai-speech風格的名稱,可能無法用於Kokoro。
保持伺服器執行
若要讓Kokoro-FastAPI在背景自動保持執行,請使用Docker的重新啟動旗標:
現在,每次重新啟動時它都會隨Docker Desktop自動啟動。
openedai-speech設定(Piper和XTTS-v2)
openedai-speech 提供OpenAI相容的 /v1/audio/speech 端點,正是Social Stream所需的格式。其小型映像檔在CPU上執行Piper,完整映像檔則可在支援的GPU上執行XTTS-v2聲音複製。
方案A:輕量級Piper
此選項適用於小於1 GB、僅使用CPU的文字轉語音伺服器,不包含XTTS-v2或聲音複製。
使用Docker Compose安裝
docker-compose.min.yml。也可以直接執行以下指令。
Windows原始碼安裝說明
如果從本機儲存庫而非Docker執行openedai-speech,請將其虛擬環境的指令碼資料夾加入 PATH ,然後再啟動伺服器。否則,請求可能回傳HTTP 500,因為伺服器找不到 piper.exe 或 ffmpeg.exe.
可用聲音
openedai-speech使用OpenAI風格的聲音名稱,並對應到Piper聲音:
SSN URL
方案B:XTTS-v2聲音複製
XTTS-v2本身是模型,而不是Web API。請使用完整的openedai-speech伺服器來載入模型、選擇已儲存的參考聲音、接收SSN的聊天文字,並回傳可播放的音訊。伺服器報告的實用目標約為4 GB GPU顯示記憶體;CPU推論也可行,但速度慢。
openedai-speech-min 用於XTTS-v2。 精簡映像檔僅包含Piper。XTTS-v2需要完整安裝及 model=tts-1-hd ,用於每次語音請求。
在macOS或Linux上使用 cp sample.env speech.env 而不是 Copy-Item。Docker必須能存取受支援的GPU。首次使用時會下載模型。
tts-1-hd 區段,位於 config/voice_to_speaker.yaml:保留已列在以下項目中的現有聲音: tts-1-hd。變更 me 改為希望SSN傳送的聲音名稱,並在需要時使用正確的XTTS語言代碼。
openaimodel=tts-1-hd 是XTTS-v2所必需的。 如果省略,Social Stream會傳送預設的 tts-1,openedai-speech會改用Piper。該 voiceopenai 值必須與以下設定中的複製聲音名稱一致: voice_to_speaker.yaml.
如果瀏覽器或OBS阻止直接請求,請執行 本機文字轉語音橋接服務 ,在OBS電腦上執行,變更以下值時保持模型和聲音參數不變: openaiendpoint 為 http://127.0.0.1:8124/v1/audio/speech.
本機文字轉語音橋接服務
橋接服務是一個小型本機輔助程式。它接收SSN的瀏覽器請求,與文字轉語音伺服器通訊,再將音訊連同適合瀏覽器的回應標頭回傳給SSN。
http://127.0.0.1:8124/v1/audio/speech,即使實際的文字轉語音伺服器在另一台電腦上。

獨立啟動套件資料夾為 local-tts-bridge/;請參閱 橋接服務README 以查看所有啟動選項。
OpenAI相容代理
Windows PowerShell,文字轉語音伺服器在同一台電腦時:
Windows PowerShell,文字轉語音伺服器在另一台電腦時:
macOS/Linux終端機:
然後將OBS的 dock.html URL指向橋接服務:
GPT-SoVITS代理模式
GPT-SoVITS使用自己的 /tts JSON格式,因此橋接服務可以將SSN的OpenAI相容請求轉換為GPT-SoVITS請求本文。
F5-TTS伺服器代理模式
某些F5-TTS伺服器封裝提供 /synthesize_speech/?text=...&voice=... ,而不是OpenAI相容端點。橋接服務可以將SSN請求轉換為該查詢格式。
http://127.0.0.1:8124/v1/audio/speech。透過以下選項變更連接埠: SSN_TTS_BRIDGE_PORT=8125 (如有需要)。
連接到Social Stream Ninja
以上所有自行代管伺服器都使用相同的連線方式,即Social Stream內建的 OpenAI文字轉語音端點 功能,並使用自訂本機URL。
URL參數
| 參數 | 值 | 說明 |
|---|---|---|
ttsprovider |
customtts 或 openai |
使用OpenAI相容的文字轉語音路徑。使用 customtts 用於本機/自行代管端點。 |
openaiendpoint |
http://localhost:8880/v1/audio/speech |
本機伺服器URL(依需要變更連接埠) |
speech |
en-US |
啟用英語文字轉語音 |
voiceopenai |
af_bella |
聲音名稱(取決於伺服器) |
openaiformat |
mp3 |
音訊格式:mp3、wav、opus、flac |
openaispeed |
1.0 |
語速(0.5–2.0) |
customttsendpoint 和 localttsendpoint 也可以使用。 customttsvoice, localttsvoice, customttsmodel, localttsmodel, customttsformat,以及 localttsformat 是OpenAI風格欄位接受的別名。
openaiendpoint 必須能從播放文字轉語音的頁面存取,而且 voiceopenai 必須是伺服器支援的聲音。Kokoro-FastAPI使用的名稱例如 af_bella;openedai-speech常使用以下名稱: nova 或 echo.
完整範例URL
Kokoro-FastAPI:
openedai-speech:
kokoro-web:
其他文字轉語音選項
這些選項適用於任何文字轉語音提供者,包括本機伺服器:
| 參數 | 範例 | 說明 |
|---|---|---|
simpletts |
&simpletts |
略過「說」字,只朗讀訊息 |
simpletts2 |
&simpletts2 |
完全略過使用者名稱 |
volume |
&volume=0.8 |
音量(0.0–1.0) |
skipmessages |
&skipmessages=3 |
每3則訊息只朗讀1則 |
ttscommand |
&ttscommand=!say |
僅朗讀以!say開頭的訊息 |
readevents |
&readevents |
同時朗讀訂閱、贊助等 |
ttsquick |
&ttsquick=100 |
刻意在指定字元數後截斷語音。如果訊息被截短,請移除此選項。 |
值得支援的內建瀏覽器選項
SSN已支援作業系統/瀏覽器的 speechSynthesis、內建Kokoro、Piper、Kitten和eSpeak。今後最實用的瀏覽器端改進是音訊輸出裝置選擇器,在以下條件下使用: setSinkId 可用時,以及更多Piper聲音選項,並為能串流輸出音訊片段的伺服器提供專用的漸進式串流播放路徑。
將音訊送入OBS
在OBS中擷取文字轉語音音訊的方法,取決於您如何執行Social Stream Ninja。
方法1 — OBS瀏覽器來源 建議
這是最簡單的方法,適用於 所有文字轉語音提供者 (內建和自行代管伺服器)。
dock.html 帶文字轉語音參數的URL方法2 — SSN桌面應用程式+桌面音訊
如果使用Social Stream Ninja獨立桌面應用程式,而不是OBS瀏覽器來源:
- Windows: VB-Audio Virtual Cable (免費)
- 設定 CABLE Input 作為Windows音效設定中SSN應用程式的輸出
- 擷取 CABLE Output ,在OBS中使用音訊輸入擷取
Windows音訊路由連結
Windows 10依應用程式路由
Windows 11依應用程式路由
Audio Router軟體
Audio Router 可以將單一應用程式路由到虛擬音訊線,但這是較舊的軟體。如果Windows依應用程式路由可用,請優先使用它。
Voicemeeter進階路由
Voicemeeter 最適合需要在本機聽到文字轉語音、將其送入OBS,並與音樂或遊戲音訊分開的情況。
?speech=en-US 且未指定提供者時)取決於瀏覽器提供的聲音。 OBS可能不提供聲音,也可能列出聲音卻無法產生可擷取的音訊。請分別測試朗讀和OBS錄製。使用上方的某個提供者(kokoro, piper等)作為替代。
比較表
| 選項 | 設定 | 品質 | 私人 | OBS(瀏覽器來源) | 需要GPU | 費用 |
|---|---|---|---|---|---|---|
| 內建Kokoro | 無 | ⭐⭐⭐⭐⭐ | 是 | 是 | 不需要(使用後更快) | 免費 |
| 內建Piper | 無 | ⭐⭐⭐⭐ | 是 | 是 | 否 | 免費 |
| 內建Kitten | 無 | ⭐⭐⭐ | 是 | 是 | 否 | 免費 |
| 內建eSpeak | 無 | ⭐⭐ | 是 | 是 | 否 | 免費 |
| Kokoro-FastAPI | Docker | ⭐⭐⭐⭐⭐ | 是 | 是 | 不需要(選用) | 免費 |
| openedai-speech | Docker | ⭐⭐⭐⭐ | 是 | 是 | 否 | 免費 |
| ElevenLabs | API金鑰 | ⭐⭐⭐⭐⭐ | 否 | 是 | 否 | 付費方案 |
| 系統 TTS | 無 | ⭐⭐ | 是 | 否* | 否 | 免費 |
* 系統文字轉語音需要透過虛擬音訊線路由,才能由OBS擷取。
疑難排解
SSN應用程式內測試正常,但OBS沒有聲音
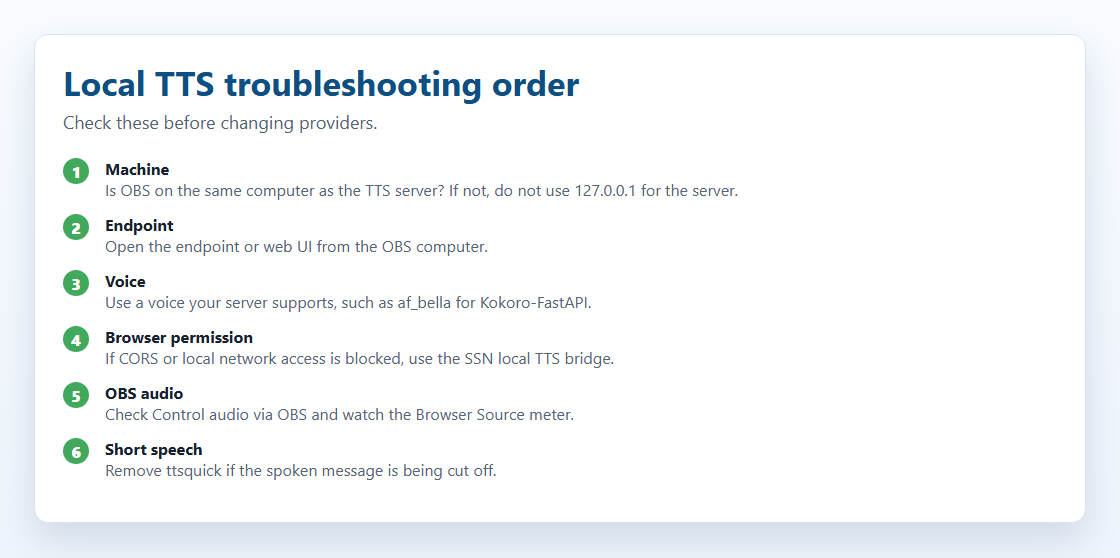
應用程式內測試只能證明應用程式能夠存取伺服器。OBS瀏覽器來源仍需能夠存取端點並播放音訊。
- 如果OBS與文字轉語音伺服器位於不同電腦,請替換
127.0.0.1替換為文字轉語音伺服器電腦的區域網路IP。 - 請確認OBS瀏覽器來源已設定 透過 OBS 控制音訊 已勾選。
- 如果瀏覽器阻止請求,請嘗試在OBS電腦上執行SSN本機文字轉語音橋接服務。
只朗讀第一個字母或前幾個詞
- 檢查OBS實際使用的URL是否包含
ttsquick。該選項會刻意縮短朗讀文字。 - 如果看到
&ttsquick=14或其他較小數值,請移除並重新整理OBS瀏覽器來源。 - 如果使用
typewriter=,請在測試時暫時移除。文字轉語音通常使用原始訊息,但移除視覺效果可快速排除時序問題。
本機伺服器無回應
- 確認Docker正在執行,且容器仍處於啟動狀態。
- 在文字轉語音伺服器電腦上開啟
http://127.0.0.1:8880/web/用於Kokoro-FastAPI,或使用伺服器對應的連接埠。 - 在執行OBS的電腦上開啟
http://SERVER_LAN_IP:8880/web/。如果無法載入,OBS也無法使用該伺服器。 - 如果區域網路IP無法載入,請檢查伺服器電腦的防火牆。
CORS或本機網路被阻止
如果瀏覽器提示請求被CORS、本機網路存取、私人網路存取或failed fetch阻止,文字轉語音伺服器可能根本沒有收到請求。
- 執行
npm run local-tts-bridge,在OBS電腦上執行,並將SSN指向http://127.0.0.1:8124/v1/audio/speech. - 如果使用代管的beta停駐面板頁面,本機HTTP端點更容易被瀏覽器阻止。使用橋接服務或本機應用程式視窗通常更簡單。
聲音錯誤或找不到聲音
- Kokoro-FastAPI:嘗試
af_bella,af_sarah,am_adam,或Kokoro網頁介面中的其他聲音。 - openedai-speech:聲音例如
nova,echo,以及alloy可能有效。 - 某些伺服器的聲音名稱區分大小寫。
可以播放音訊,但OBS未擷取
- 請確認 透過 OBS 控制音訊 已在瀏覽器來源屬性中勾選。
- 播放測試訊息時,觀察OBS音訊混音器。瀏覽器來源的音量表應有變化。
- 請確認沒有只使用系統文字轉語音(
?speech=en-US不帶&ttsprovider=)。系統文字轉語音可能需要擷取桌面音訊或使用虛擬音訊線。
找不到Docker映像檔
Docker映像檔標籤可能變更。如果本指南中的指令不再有效,請到專案頁面查看目前標籤:
- Kokoro-FastAPI: github.com/remsky/Kokoro-FastAPI
- openedai-speech: github.com/matatonic/openedai-speech