
1. チャット読み上げをオンにする
まだチャットを接続していない場合 ここから開始:SSNをインストールし、ソースを追加してドックを開きます。
開く項目: SSN拡張機能のポップアップ 、またはデスクトップアプリの ソースと設定.
次のセクションで: メインチャットオーバーレイと操作ドック(Main chat overlay & control dock)で、次を展開します: メッセージ — 読み上げ(Message — Text to Speech)。ここに示すスイッチをオンにします:
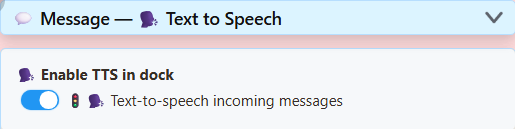
2. 無料の音声を選ぶ
同じセクションで次までスクロールします: 読み上げサービスプロバイダー(TTS Service Provider)。次を選択します: Piper TTSを選び、次に音声を選択します。
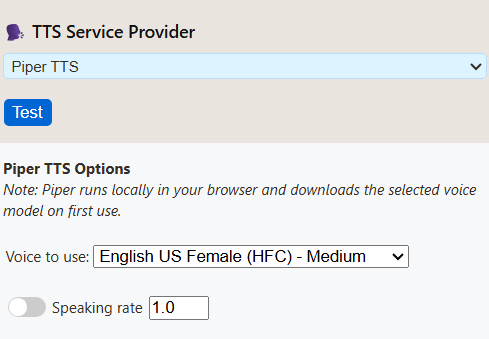
使う項目: リンクをコピー (次の項目の横にあります): メインチャットオーバーレイと操作ドック(Main chat overlay & control dock) で更新したリンクを取得します。
3. OBSで再生する
- OBSに次を追加します: ブラウザソース を追加し、そのリンクを貼り付けます。
- 有効化 OBSで音声を制御する(Control audio via OBS) をプロパティで有効にします。
- チャットメッセージを送信し、ソースの音声メーターを確認して、短く録画します。
自分でも聞きたい場合 OBSのオーディオの詳細プロパティで、次を選択します: モニターと出力(Monitor and Output) をそのソースに設定します。チャットを読み上げる画面は1つだけにしてください。
無料の音声を聞く
別の声が好みですか?この4つの音声は無料です。再生して比べてください。
スペイン語とポルトガル語のサンプル
SSN設定の音声一覧の上で言語を選び、次を使います: テスト。Piperにはスペイン、メキシコ、ブラジル、ポルトガルの音声があります。Kokoroではさらにスペイン語3音声とブラジルポルトガル語3音声を利用できます。
Piper - スペイン語(スペイン)
DaveFX
Kokoro - スペイン語
Dora
Piper - ポルトガル語(ブラジル)
Faber
Kokoro - ポルトガル語(ブラジル)
Dora
無料のローカル音声合成で、初回にダウンロードが必要です。サンプルには読み込み時間を含めていません。最初は軽いPiperが適しており、KokoroはCPUでは遅くなることがあります。読み上げがチャットに追いつかない場合はPiperを使ってください。
サンプル文とテストの詳細
4つの英語サンプルの読み上げ文: 配信へようこそ!来てくれてありがとう。次はどのゲームで遊びましょうか? 名前の読み上げは無効です。
2026年9月7日、Windows 11のOBS 32.2.2で確認:チャットメッセージが実際のドックに届き、音声が生成され、ブラウザソースのメーターが動き、録画にも収録されました。このCPUテストでは、Kokoroの読み上げ開始が明らかに遅くなりました。これらのクリップは音声のサンプルであり、待ち時間を示すものではありません。
この端末ではSystem TTSに5つの音声が表示されましたが、ブラウザソースの録画には音声が入りませんでした。この結果は今回の構成でのものです。必ず最終的なURLと録画でテストしてください。有料の認証情報を使用していないため、クラウド音声は含まれていません。
お困りですか?
使っているチャットプラットフォームはTTSに対応していますか?
SSNがチャットをテキストとして受信できれば、読み上げられます。YouTube、Twitch、TikTokなど、どのソースでも同じ機能を使います。チャットプラットフォーム自体のTTS対応は不要です。
読み上げられない場合
ドックがチャットを受信していることを確認し、その後TTSスイッチ、プロバイダー、フィルターを確認します。新しくコピーしたリンクを使ってください。初回のモデルダウンロードが終わるまで待ちます。
Chrome/Edgeでは動くのにOBSでは動かない場合
OBSには独立したブラウザと音声一覧があります。音声が一覧に表示されても、System TTSが動かない場合があります。Piper、Kokoro、Kitten、eSpeakを試してください。音声が生成されない問題は、仮想オーディオケーブルでは解決できません。
メーターは動くのに録画が無音の場合
OBSのミュートと録画トラックの割り当てを確認してください。自分でも聞きたい場合はMonitor and Outputを使い、モニター出力を二重に取り込まないようにします。 OBS音声ガイド.
OBSドックやFeatured Chatでも使えますか?
OBSのカスタムブラウザドックは操作パネルであり、上で使ったシーン内のブラウザソースとは別です。Featured Chatの場合は、そのオーバーレイ独自のポップアップ設定でTTSを有効にし、リンクをコピーしてください。声が二重にならないよう、読み上げるページは1つにします。
全プロバイダーを比較:要件、費用、考慮する点
無料のローカル音声はPiperから始めてください。Kokoroの声が好みなら、聞き比べてみましょう。 自然さより反応の速さを重視する場合はeSpeakを試してください。Kittenも小型の英語音声の選択肢です。聞いてから決めましょう。
| プロバイダー | 適した用途 | 考慮する点 | 要件 / 費用 |
|---|---|---|---|
| Kokoro | 英語、スペイン語、ブラジルポルトガル語の音声。 | CPU負荷が高めで、最初の読み上げが遅くなる場合があります。 | 無料、キー不要。モデル/音声アセットをダウンロードします。CPUまたは対応するWebGPUを使用します。 |
| Piper | ローカルのニューラル音声。英語、スペイン語、ポルトガル語を選べます。 | 品質と発音は音声によって異なります。 | 無料、キー不要。選択したモデル(HFC mediumは約63 MB)とエンジンファイルをダウンロードします。 |
| Kitten | 小型の英語モデル。8つの音声を選べます。 | 言語と音声スタイルの種類は少なめです。 | 無料、キー不要。現在の同梱モデルは約24 MBで、別途エンジン/音声ファイルが必要です。CPUを使用します。 |
| eSpeak | 軽量で多言語に対応し、すぐに開始できます。 | 意図的に合成音声らしい、ロボット風の音です。 | 無料、キー不要。同梱のエンジン/言語ファイルを読み込みます。ニューラルモデルやGPUは不要です。 |
| システム読み上げ(System TTS) | ブラウザやデスクトップアプリが提供する音声を使います。 | 音声一覧とOBSでの取得は環境によって異なり、インターネット接続が必要な音声もあります。 | SSNのプロバイダー料金はありません。動作するシステム/ブラウザ音声が必要です。実際に再生するページでテストしてください。 |
| ElevenLabs | 音声ID、モデル選択、安定性/スタイルの操作。 | アカウントの制限、ネットワーク遅延、API料金が発生する場合があります。 | インターネット接続、APIキー、利用可能な音声ID。チャットテキストはプロバイダーに送信されます。 |
| Google Cloud | 名前付き音声と、言語、速度、ピッチの操作。 | すべての音声がすべての操作に対応するわけではありません。 | インターネット接続、有効なCloud TTS API、APIキー、一致する音声/言語。課金/割り当てが適用されます。 |
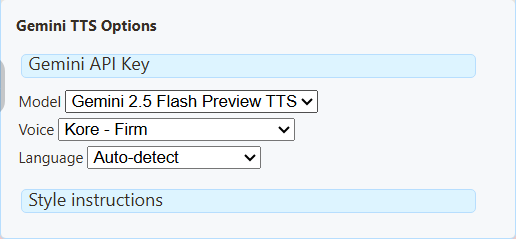
| Gemini | 音声スタイルと、文章で指定する話し方の指示。 | プレビューモデルと割り当ては変わる場合があり、遅延も異なります。 | インターネット接続、Gemini APIキー、選択したTTSモデルへの利用権限。アカウントの上限/課金を確認してください。 |
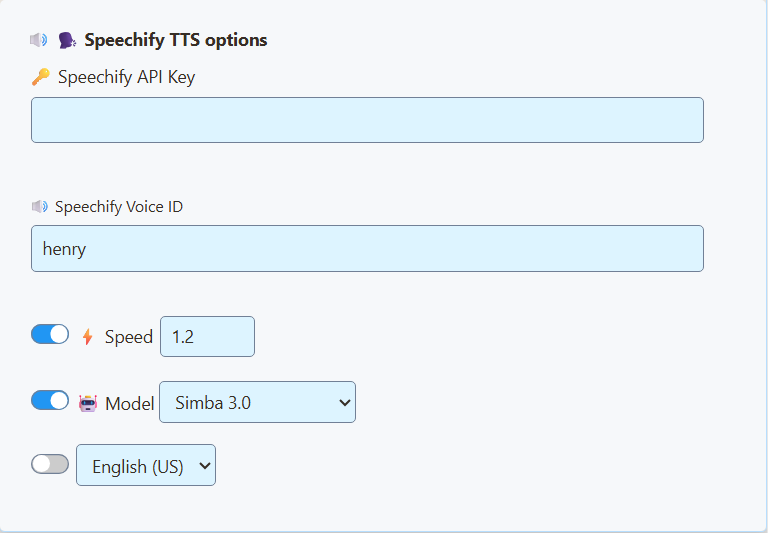
| Speechify | 音声IDと、速度、言語、モデルの操作。 | API利用権限が必要です。利用可能な音声はアカウントによって異なります。 | インターネット接続とSpeechify APIキー。API利用条件/上限が適用されます。 |
| OpenAI | 名前付き音声と、モデル、形式の操作。 | API課金とインターネット接続が必要です。アカウントのサブスクリプションとは別です。 | TTS利用権限のあるAPIキー。チャットのテキストは設定したエンドポイントに送信されます。 |
| カスタム / ローカル | 自分の互換音声サーバーを使えます。 | 設定項目が最も多く、エンドポイント、モデル、音声、ブラウザからのアクセスを一致させる必要があります。 | 到達可能なOpenAI互換の音声エンドポイントと、必要な場合はキー。ローカル機器やホスティングの費用は構成によって異なります。 |
上のダウンロードサイズはモデルファイルのみで、総メモリ使用量や必要な全アセットのサイズではありません。ローカルプロバイダーはドック/オーバーレイを実行するコンピューターを使います。初回は遅くなる場合があり、OBSには独自のキャッシュがあります。クラウドプロバイダーはローカル計算量を減らしますが、テキストを端末外へ送信します。
OBS: 以下の4つのローカルプロバイダーは、ブラウザソースの録画テストに合格しました。クラウド/カスタムプロバイダーはページで再生する音声を返しますが、今回の確認では実際のアカウントでテストしていません。System TTSは音声一覧が表示されても、別途テストが必要です。
プロバイダー設定と音声名
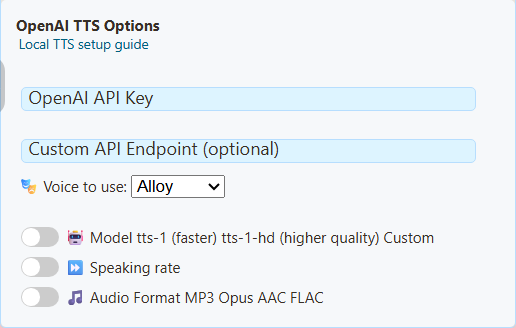
新しいプロファイルで撮影した、実際のデスクトップアプリ設定です。希望するプロバイダーを開いてください。APIキー欄は意図的に空欄にしています。これらの操作項目は、選択したSSNドックまたはオーバーレイを設定します。画像を選ぶと原寸で表示できます。
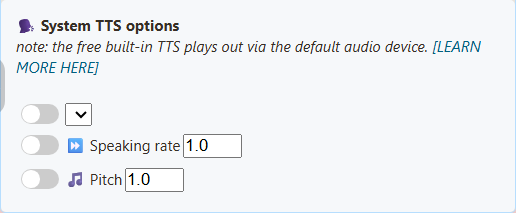
システム読み上げ(System TTS)
この新しいプロファイルでは言語一覧が空です。利用できる音声はブラウザ/アプリとインストール済み音声によって異なり、すべての環境で共通のSSN音声一覧はありません。
Kokoro
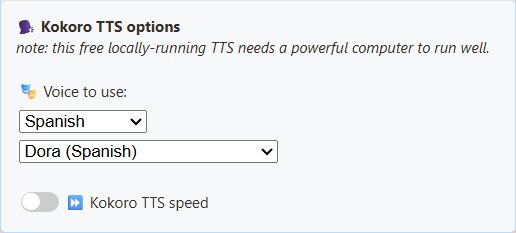
SSNで音声を選ぶと、読み上げるページでモデルが読み込まれます。アメリカ/イギリス英語、スペイン語、ブラジルポルトガル語の音声があります。言語フィルターで音声を探せます。Testは選択言語の短い文を再生します。CPU負荷を下げたい場合はPiperを試してください。
音声名とURLの値
- Heart(アメリカ英語・女性)—
af_heart - Alloy(アメリカ英語・女性)—
af_alloy - Aoede(アメリカ英語・女性)—
af_aoede - Bella(アメリカ英語・女性)—
af_bella - Jessica(アメリカ英語・女性)—
af_jessica - Kore(アメリカ英語・女性)—
af_kore - Nicole(アメリカ英語・女性)—
af_nicole - Nova(アメリカ英語・女性)—
af_nova - River(アメリカ英語・女性)—
af_river - Sarah(アメリカ英語・女性)—
af_sarah - Sky(アメリカ英語・女性)—
af_sky - Adam(アメリカ英語・男性)—
am_adam - Echo(アメリカ英語・男性)—
am_echo - Eric(アメリカ英語・男性)—
am_eric - Fenrir(アメリカ英語・男性)—
am_fenrir - Liam(アメリカ英語・男性)—
am_liam - Michael(アメリカ英語・男性)—
am_michael - Onyx(アメリカ英語・男性)—
am_onyx - Puck(アメリカ英語・男性)—
am_puck - Santa(アメリカ英語・男性)—
am_santa - Emma(イギリス英語・女性)—
bf_emma - Isabella(イギリス英語・女性)—
bf_isabella - George(イギリス英語・男性)—
bm_george - Lewis(イギリス英語・男性)—
bm_lewis - Alice(イギリス英語・女性)—
bf_alice - Lily(イギリス英語・女性)—
bf_lily - Daniel(イギリス英語・男性)—
bm_daniel - Fable(イギリス英語・男性)—
bm_fable - Dora(スペイン語)-
ef_dora - Alex(スペイン語)-
em_alex - Santa(スペイン語)-
em_santa - Dora(ブラジルポルトガル語)-
pf_dora - Alex(ブラジルポルトガル語)-
pm_alex - Santa(ブラジルポルトガル語)-
pm_santa
Kitten
英語の8音声:男性と女性それぞれに2、3、4、5の番号があります。サンプルはVoice 4(Female)を使っています。
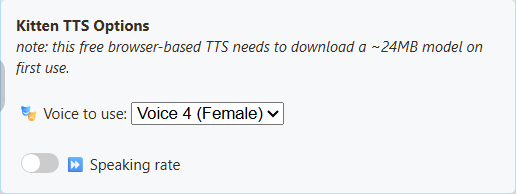
音声名とURLの値
- Voice 2(男性)—
expr-voice-2-m - Voice 2(女性)—
expr-voice-2-f - Voice 3(男性)—
expr-voice-3-m - Voice 3(女性)—
expr-voice-3-f - Voice 4(男性)—
expr-voice-4-m - Voice 4(女性)—
expr-voice-4-f - Voice 5(男性)—
expr-voice-5-m - Voice 5(女性)—
expr-voice-5-f
Piper
一致する言語とモデルを選んでください。サンプルはHFC mediumを使います。言語設定だけで音声が翻訳されるわけではありません。
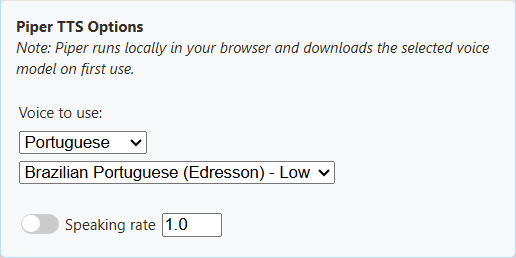
音声名とURLの値
- アメリカ英語・女性(HFC)- 中品質 —
en_US-hfc_female-medium - スペイン語(スペイン)(DaveFX)- 中品質 —
es_ES-davefx-medium - スペイン語(メキシコ)(Ald)- 中品質 —
es_MX-ald-medium - ブラジルポルトガル語(Faber)- 中品質 —
pt_BR-faber-medium - ブラジルポルトガル語(Edresson)- 低品質 —
pt_BR-edresson-low - ポルトガル語(ポルトガル)(Tugao)- 中品質 —
pt_PT-tugão-medium
eSpeak
対象言語の音声を選び、必要に応じて発話速度を調整します。このエンジンは、意図的にロボットのような音声になっています。
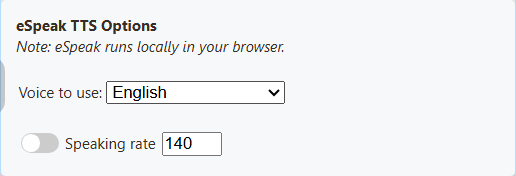
音声名とURLの値
- 英語 —
en - スペイン語 —
es - ポルトガル語(ブラジル)—
pt-br - ポルトガル語(ポルトガル)—
pt-pt
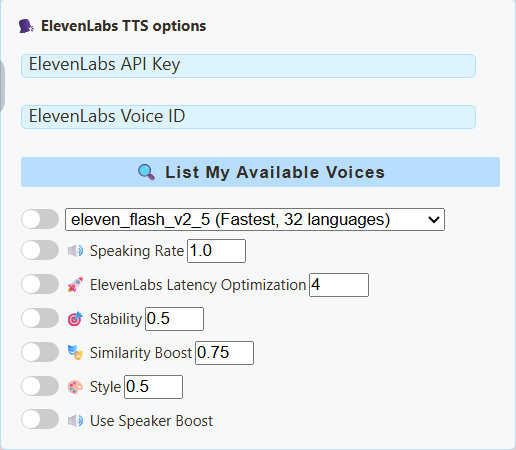
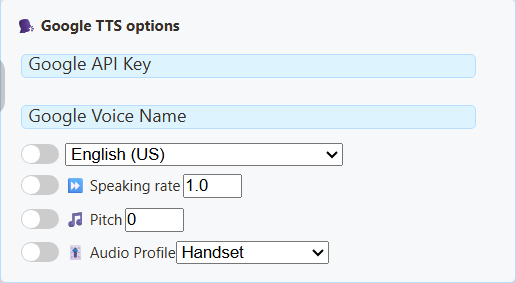
Fish Audio
選択する項目: Fish Audio を、チャットドック、選択メッセージオーバーレイ、TTSページ、Flow ActionsのTTSプロバイダーメニューで選択します。自分の次の値を入力してください: Fish Audio APIキーを入力し、既存のTest TTSボタンを使います。任意のVoice IDでは、次から音声を選べます: Fish Audio。名前やページURLではなく、音声モデルIDをコピーしてください。空欄にするとサービスの標準音声を使います。
詳細設定にはモデルと発話速度(0.5〜2)があります。SSNの標準値は s2.1-pro-free。無料枠の利用可否とフェアユース条件はFish Audioが定めます。有料モデルにはアカウントのクレジットが必要です。SSNは無料リクエストが失敗しても、有料モデルで再試行しません。視聴者向け音量にはMore TTS optionsを使ってください。テキストはFish Audioへ送信され、言語はサービス側が検出します。
OBS / ブラウザの設定: SSNの既存の次を実行します: FishモードのローカルTTSブリッジ をOBSのコンピューターで実行します。次を設定します: SSN_TTS_TARGET_BEARER 環境変数をFish APIキーに設定し、次を起動します: node scripts/local-tts-bridge.cjs --mode fish。Fish Audioパネルで次を設定します: OBS / ブラウザブリッジURL → http://127.0.0.1:8124/v1/audio/speech。ターミナルに表示されたローカルブリッジのトークンを、ポップアップの次の欄へ貼り付けます: APIキー 欄へ貼り付けます。次を設定しない限り、トークンは再起動時に変わります: SSN_TTS_BRIDGE_TOKEN を長いランダムな秘密値にしてください。トークンを含むオーバーレイリンクは非公開にします。ブリッジを起動したまま音声をテストし、生成したオーバーレイURLをOBSで使ってください。OBSミキサーで音声を扱うには、ブラウザソース設定のControl audio via OBSを有効にします。ホストされたブラウザページからFishへの直接リクエストにはCORS許可がありません。ブリッジがブラウザからアクセスできる音声応答を提供します。
ブリッジを使う場合は、次を追加します: &fishendpoint=http%3A%2F%2F127.0.0.1%3A8124%2Fv1%2Faudio%2Fspeech をURLに追加し、次は省略します: fishkey 。ブリッジがキーを保持する場合の設定です。
URLパラメータ: &ttsprovider=fish&fishkey=YOUR_KEY&voicefish=VOICE_ID&fishmodel=s2.1-pro-free&fishspeed=1。通常の操作でTTSを有効にしてください。キーを含む生成URLは非公開にします。受信ページがFish Audioを使っている場合、Event Flowの既存のSpeak Textの音声上書きにはFishの音声IDを指定できます。
OpenAI
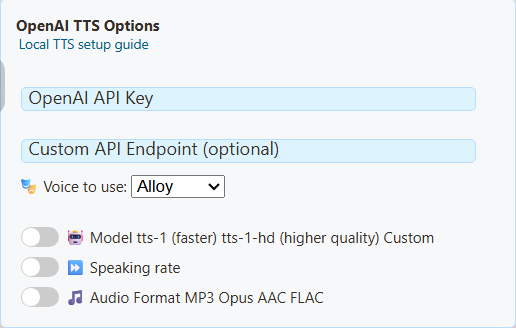
対応する音声/モデルを選び、APIキーを入力してください。ChatGPTのサブスクリプションにAPIクレジットは含まれません。OpenAIを使う場合は標準エンドポイントを維持してください。
カスタム / ローカルTTS(Custom / Local TTS)
このオプションはOpenAI互換の操作項目を再利用するため、見出しはOpenAIのままです。自分のサーバーのエンドポイントと対応する音声/モデルを入力してください。認証はサーバーによって異なります。参照: ローカルサーバーガイド.
高度な設定:TTS URLを手動で編集する
最初に試すおすすめ:
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kokoro
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=piper
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kitten
ポルトガル語やスペイン語では、代わりに次のいずれかから始めてください:
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=piper&pipervoice=pt_BR-faber-medium
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=espeak&espeakvoice=pt-br
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=piper&pipervoice=es_ES-davefx-medium
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=espeak&espeakvoice=es
高度な設定:自分のローカルTTSサーバーを動かす
非公開の音声、特定の音声モデル、Kokoro-FastAPIやopenedai-speechなどのサーバーを使いたい場合に、ローカルTTSサーバーが役立ちます。TTSを再生するページからエンドポイントへ到達できる必要があります。

dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=af_bella
localhost は、そのページを実行するコンピューターを指します。TTSサーバーが別のコンピューターにある場合は、そのLAN IPを使うか、OBSのコンピューターでブリッジを実行してください。