
1. Ative a leitura do chat
Ainda sem chat conectado? Comece aqui: instale o SSN, adicione sua fonte e abra o dock.
Abra: popup da extensão SSN ou a seção do aplicativo para desktop chamada Fontes e configurações.
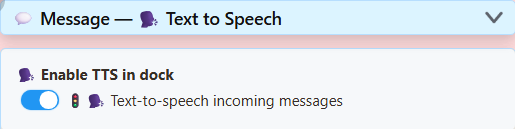
Em Overlay principal de chat e dock de controle, expanda Mensagem — Texto em fala (Message — Text to Speech). Ative o interruptor mostrado aqui:
2. Escolha uma voz gratuita
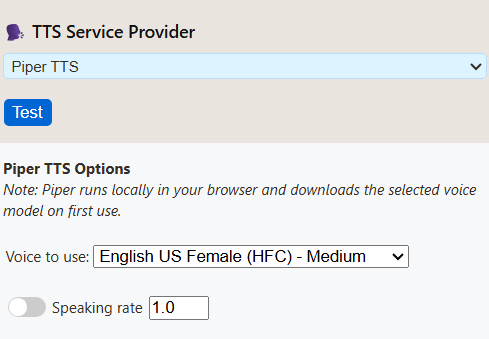
Na mesma seção, role até Provedor de serviço TTS. Escolha Piper TTS, depois uma voz.
Use copiar link ao lado de Overlay principal de chat e dock de controle para obter o link atualizado.
3. Reproduza no OBS
- Adicione no OBS uma Fonte de navegador e cole esse link.
- Ative Controlar áudio pelo OBS (Control audio via OBS) nas propriedades.
- Envie uma mensagem no chat. Verifique o medidor de áudio da fonte e faça uma gravação curta.
Quer ouvir também? Nas Propriedades avançadas de áudio do OBS, escolha Monitorar e enviar (Monitor and Output) para essa fonte. Mantenha apenas uma cópia lendo o chat.
Ouça as vozes gratuitas
Prefere outro som? Estas quatro vozes são gratuitas. Pressione reproduzir para comparar.
Piper
Inglês dos EUA, feminina (HFC), qualidade média.en_US-hfc_female-medium
Amostras em espanhol e português
Escolha um idioma acima da lista de vozes nas configurações do SSN e depois use Teste. O Piper oferece Espanha, México, Brasil e Portugal; o Kokoro adiciona três vozes em espanhol e três em português brasileiro.
Piper - Espanhol (Espanha)
DaveFX
Kokoro - Espanhol
Dora
Piper - Português (Brasil)
Faber
Kokoro - Português (Brasil)
Dora
Síntese local gratuita com download inicial. As amostras omitem o tempo de carregamento. Piper é o ponto de partida mais leve; Kokoro pode ser lento em CPU. Use Piper se a fala ficar atrasada em relação ao chat.
Texto das amostras e detalhes dos testes
As quatro amostras em inglês leem: Bem-vindo à transmissão! Obrigado por participar. Qual jogo devemos jogar a seguir? A leitura dos nomes está desativada.
Verificado em 7 de setembro de 2026 no OBS 32.2.2, Windows 11: uma mensagem de chat chegou ao dock real, gerou fala, moveu o medidor da fonte de navegador e apareceu em uma gravação. O Kokoro demorou consideravelmente mais para começar a falar neste teste em CPU. Estes clipes mostram a voz, não o tempo de espera.
O TTS do sistema disponibilizou cinco vozes nesta máquina, mas não produziu áudio na gravação da fonte de navegador. Esse resultado é específico desta configuração; sempre teste a URL final e a gravação. Vozes de nuvem não estão incluídas porque não foram usadas credenciais pagas.
Precisa de ajuda?
Minha plataforma de chat suporta TTS?
Se o SSN recebe o chat como texto, pode lê-lo em voz alta. YouTube, Twitch, TikTok e outras fontes usam o mesmo recurso. Sua plataforma de chat não precisa ter suporte próprio a TTS.
Sem fala?
Verifique se o dock recebe chat e depois confira o interruptor de TTS, provedor e filtros. Use o link recém-copiado. Aguarde o primeiro download do modelo terminar.
Funciona no Chrome/Edge, mas não no OBS?
O OBS tem um navegador e uma lista de vozes separados. O TTS do sistema pode não funcionar nele, mesmo quando lista vozes. Experimente Piper, Kokoro, Kitten ou eSpeak. Um cabo de áudio virtual não corrige ausência de fala.
O medidor se move, mas a gravação está sem som?
Verifique o mudo e a atribuição de faixas de gravação no OBS. Use Monitorar e enviar se também quiser ouvir; evite capturar essa saída de monitoramento uma segunda vez. Guia de áudio do OBS.
Posso usar um dock do OBS ou chat em destaque?
Um dock personalizado de navegador do OBS é um painel de controle, não a fonte de navegador da cena usada acima. Para chat em destaque, ative TTS nas próprias opções do popup dessa sobreposição e copie o link. Mantenha uma única página falando para evitar vozes duplicadas.
Compare todos os provedores: requisitos, custo e limitações
Comece com Piper para uma voz local gratuita ou compare Kokoro se preferir seu som. Experimente eSpeak quando a rapidez de resposta for mais importante que o realismo. Kitten é outra opção compacta em inglês. Ouça antes de decidir.
| Provedor | Bom para | Limitação | Requisitos / custo |
|---|---|---|---|
| Kokoro | Vozes em inglês, espanhol e português brasileiro. | Mais trabalho de CPU; a primeira fala pode demorar. | Gratuito, sem chave. Baixa arquivos de modelo/voz; CPU ou WebGPU compatível. |
| Piper | Vozes neurais locais; opções em inglês, espanhol e português. | Qualidade e pronúncia variam conforme a voz. | Gratuito, sem chave. Baixa o modelo selecionado (HFC medium: cerca de 63 MB), além dos arquivos do mecanismo. |
| Kitten | Modelo compacto em inglês, oito opções de voz. | Menos idiomas e estilos de voz. | Gratuito, sem chave. Modelo incluído atual: cerca de 24 MB, além dos arquivos de mecanismo/voz; CPU. |
| eSpeak | Leve, muitos idiomas, início rápido. | Som deliberadamente sintético/robótico. | Gratuito, sem chave. Carrega arquivos de mecanismo/idioma incluídos; não exige modelo neural nem GPU. |
| Síntese de voz do sistema | Usa as vozes disponibilizadas pelo navegador ou aplicativo para desktop. | A lista de vozes e a captura no OBS variam; algumas vozes precisam de internet. | Sem taxa de provedor do SSN. Exige uma voz funcional do sistema/navegador; teste na página real de reprodução. |
| ElevenLabs | IDs de voz, seleção de modelo e controles de estabilidade/estilo. | Podem se aplicar limites da conta, atraso de rede e cobranças de API. | Internet, chave de API e ID de voz acessível. O texto do chat vai para o provedor. |
| Google Cloud | Vozes identificadas pelo nome e controles de idioma, velocidade e tom. | Nem todas as vozes aceitam todos os controles. | Internet, API Cloud TTS ativada, chave de API e voz/idioma correspondentes. Aplicam-se faturamento/cotas. |
| Gemini | Estilos de voz e instruções escritas de interpretação. | Modelos em prévia e cotas podem mudar; a latência varia. | Internet, chave de API do Gemini e acesso ao modelo de TTS selecionado. Verifique limites/faturamento da conta. |
| Speechify | ID de voz com controles de velocidade, idioma e modelo. | Precisa de acesso à API; as vozes disponíveis dependem da conta. | Internet e chave de API do Speechify. Aplicam-se termos/limites de uso da API. |
| OpenAI | Vozes identificadas pelo nome com controles de modelo e formato. | Exige faturamento da API e internet; a assinatura da conta é separada. | Chave de API com acesso a TTS. O texto do chat é enviado ao endpoint configurado. |
| Personalizado / Local | Use seu próprio servidor de voz compatível. | Mais configuração: endpoint, modelo, voz e acesso do navegador precisam estar alinhados. | Um endpoint acessível de fala compatível com OpenAI; chave, se exigida. Os custos de hardware local ou hospedagem variam. |
Os tamanhos de download acima são dos arquivos de modelo, não do uso total de memória nem de todos os arquivos necessários. Provedores locais usam o computador que executa o dock/sobreposição; o primeiro uso pode ser mais lento, e o OBS tem seu próprio cache. Provedores de nuvem economizam processamento local, mas enviam o texto para fora do dispositivo.
OBS: os quatro provedores locais abaixo passaram nos testes de gravação da fonte de navegador. Provedores de nuvem/personalizados retornam áudio para a página reproduzir, mas não foram testados com contas reais nesta revisão. O TTS do sistema precisa de um teste separado, mesmo quando lista vozes.
Configurações dos provedores e nomes das vozes
Configurações reais do aplicativo para desktop, capturadas em um perfil novo. Abra o provedor desejado; os campos de chave de API estão vazios intencionalmente. Estes controles configuram o dock ou a sobreposição selecionada do SSN. Selecione uma captura para vê-la em tamanho completo.
Síntese de voz do sistema
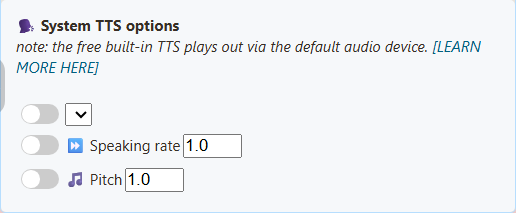
A lista de idiomas está vazia neste perfil novo. As vozes disponíveis dependem do navegador/aplicativo e das vozes instaladas; não existe uma lista universal de vozes do SSN.
Kokoro
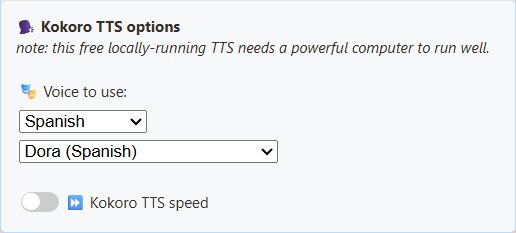
Escolha uma voz no SSN; o modelo carrega na página que fala. A seleção inclui inglês dos EUA/Reino Unido, espanhol e português brasileiro. Use o filtro de idioma para encontrar vozes; Test reproduz uma frase curta no idioma selecionado. Para menor uso de CPU, experimente Piper.
Nomes de vozes e valores de URL
- Heart (feminina americana) —
af_heart - Alloy (feminina americana) —
af_alloy - Aoede (feminina americana) —
af_aoede - Bella (feminina americana) —
af_bella - Jessica (feminina americana) —
af_jessica - Kore (feminina americana) —
af_kore - Nicole (feminina americana) —
af_nicole - Nova (feminina americana) —
af_nova - River (feminina americana) —
af_river - Sarah (feminina americana) —
af_sarah - Sky (feminina americana) —
af_sky - Adam (masculina americana) —
am_adam - Echo (masculina americana) —
am_echo - Eric (masculina americana) —
am_eric - Fenrir (masculina americana) —
am_fenrir - Liam (masculina americana) —
am_liam - Michael (masculina americana) —
am_michael - Onyx (masculina americana) —
am_onyx - Puck (masculina americana) —
am_puck - Santa (masculina americana) —
am_santa - Emma (feminina britânica) —
bf_emma - Isabella (feminina britânica) —
bf_isabella - George (masculina britânica) —
bm_george - Lewis (masculina britânica) —
bm_lewis - Alice (feminina britânica) —
bf_alice - Lily (feminina britânica) —
bf_lily - Daniel (masculina britânica) —
bm_daniel - Fable (masculina britânica) —
bm_fable - Dora (espanhol) -
ef_dora - Alex (espanhol) -
em_alex - Santa (espanhol) -
em_santa - Dora (português brasileiro) -
pf_dora - Alex (português brasileiro) -
pm_alex - Santa (português brasileiro) -
pm_santa
Kitten
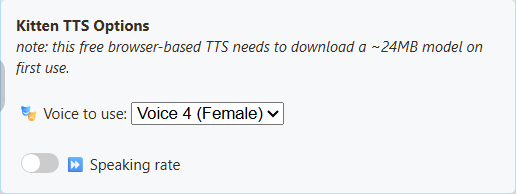
Oito vozes em inglês: variantes masculinas e femininas numeradas 2, 3, 4 e 5. A amostra usa Voice 4 (Female).
Nomes de vozes e valores de URL
- Voz 2 (masculina) —
expr-voice-2-m - Voz 2 (feminina) —
expr-voice-2-f - Voz 3 (masculina) —
expr-voice-3-m - Voz 3 (feminina) —
expr-voice-3-f - Voz 4 (masculina) —
expr-voice-4-m - Voz 4 (feminina) —
expr-voice-4-f - Voz 5 (masculina) —
expr-voice-5-m - Voz 5 (feminina) —
expr-voice-5-f
Piper
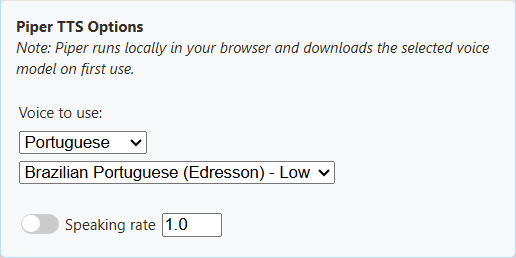
Escolha idioma e modelo correspondentes. A amostra usa HFC medium. Uma configuração de idioma sozinha não traduz uma voz.
Nomes de vozes e valores de URL
- Inglês dos EUA, feminina (HFC) - Média —
en_US-hfc_female-medium - Espanhol da Espanha (DaveFX) - Média —
es_ES-davefx-medium - Espanhol do México (Ald) - Média —
es_MX-ald-medium - Português brasileiro (Faber) - Média —
pt_BR-faber-medium - Português brasileiro (Edresson) - Baixa —
pt_BR-edresson-low - Português de Portugal (Tugao) - Média —
pt_PT-tugão-medium
eSpeak
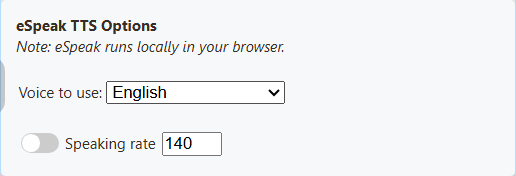
Escolha uma voz de idioma e, opcionalmente, ajuste a velocidade de fala. Este mecanismo tem som robótico por natureza.
Nomes de vozes e valores de URL
- Inglês —
en - Espanhol —
es - Português do Brasil —
pt-br - Português de Portugal —
pt-pt
ElevenLabs
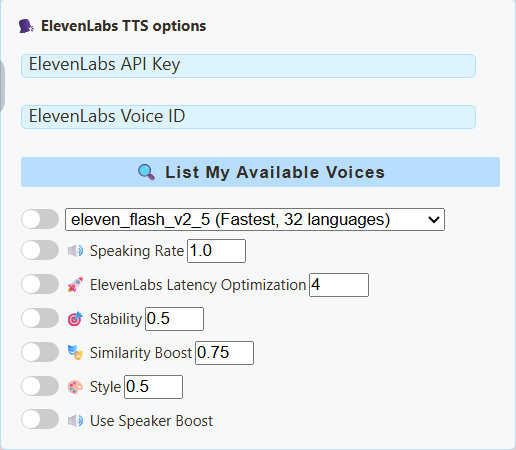
Insira sua chave de API e use List My Available Voices para encontrar um ID de voz disponível para sua conta. Referência de provedores.
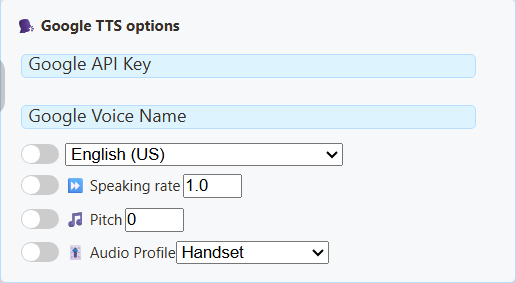
Google Cloud
Insira uma chave de API do Google Cloud TTS e o nome exato da voz, com o idioma correspondente. Nomes de vozes e controles compatíveis.
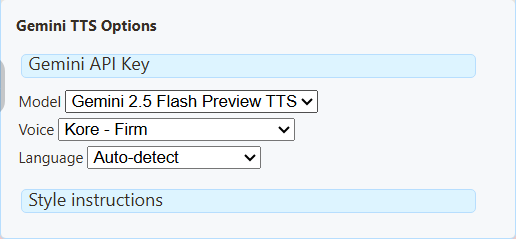
Gemini
Selecione um modelo de TTS e uma voz compatíveis; instruções de estilo alteram a interpretação. Estas são configurações da API Gemini, separadas do Google Cloud TTS. Exemplos de vozes e requisitos.
Fish Audio
Selecione Fish Audio no menu de provedor de TTS do dock de chat, sobreposição de destaque, página TTS ou Flow Actions. Insira sua própria Chave de API do Fish Audio, depois use o botão Test TTS existente. Um ID de voz opcional seleciona uma voz de Fish Audio; copie o ID do modelo de voz, não o nome nem a URL da página. Deixe vazio para usar a voz padrão do serviço.
As opções avançadas incluem modelo e velocidade de fala (0.5–2). O SSN usa por padrão s2.1-pro-free; a disponibilidade do plano gratuito e os termos de uso justo são controlados pelo Fish Audio. Modelos pagos exigem crédito na conta. O SSN não repete uma solicitação gratuita que falhou usando um modelo pago. Use Mais opções de TTS para o volume dos espectadores. O texto é enviado ao Fish Audio, e o serviço detecta o idioma.
Configuração de OBS / navegador: Execute a ferramenta existente do SSN ponte local de TTS no modo Fish no computador do OBS. Defina a variável de ambiente SSN_TTS_TARGET_BEARER com sua chave de API do Fish e inicie node scripts/local-tts-bridge.cjs --mode fish. No painel Fish Audio, defina URL da ponte para OBS / navegador como http://127.0.0.1:8124/v1/audio/speech; cole o token da ponte local impresso no terminal no campo do popup Chave de API . O token muda ao reiniciar, a menos que você defina SSN_TTS_BRIDGE_TOKEN como um segredo aleatório longo; mantenha privados os links de sobreposição que contêm token. Deixe a ponte em execução, teste a voz e use a URL gerada de sobreposição no OBS. Ative Control audio via OBS nas configurações da fonte de navegador se quiser o áudio no mixer do OBS. Solicitações diretas ao Fish a partir de páginas hospedadas não têm permissão CORS; a ponte fornece a resposta de áudio acessível ao navegador.
Com a ponte, adicione &fishendpoint=http%3A%2F%2F127.0.0.1%3A8124%2Fv1%2Faudio%2Fspeech à URL e omita fishkey quando a ponte armazena a chave.
Parâmetros de URL: &ttsprovider=fish&fishkey=YOUR_KEY&voicefish=VOICE_ID&fishmodel=s2.1-pro-free&fishspeed=1. Ative o TTS pelos controles normais. Mantenha privadas as URLs geradas que contenham sua chave. A substituição de voz existente em Speak Text do Event Flow aceita um ID de voz Fish quando a página receptora usa Fish Audio.
Referência da API do Fish Audio · Anúncio e termos do modelo gratuito
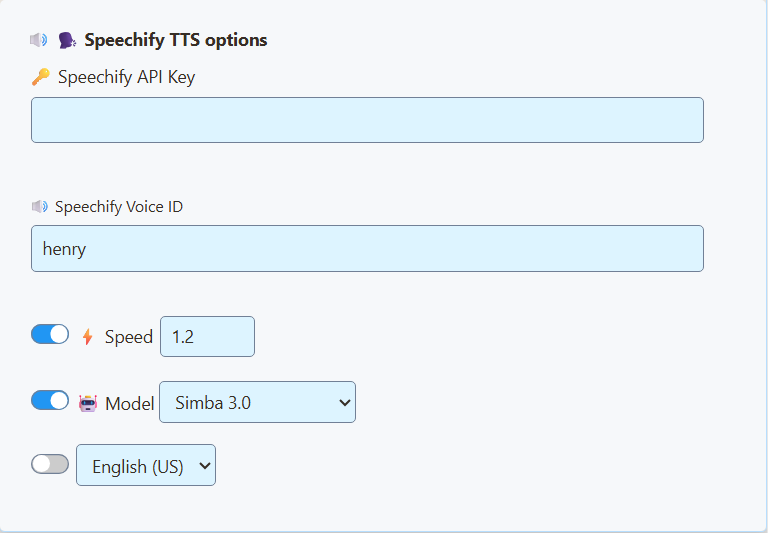
Speechify
Guia passo a passo do Speechify: chave de API, vozes, velocidade e volume dos espectadores.
Insira a chave de API e o ID da voz da sua conta de API do Speechify. Configuração do provedor.
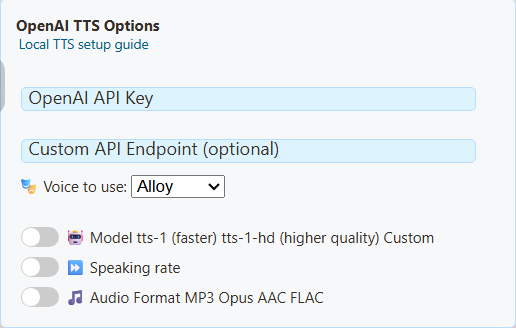
OpenAI
Escolha uma voz/modelo compatível e insira uma chave de API. Uma assinatura ChatGPT não fornece créditos de API. Mantenha o endpoint padrão para OpenAI.
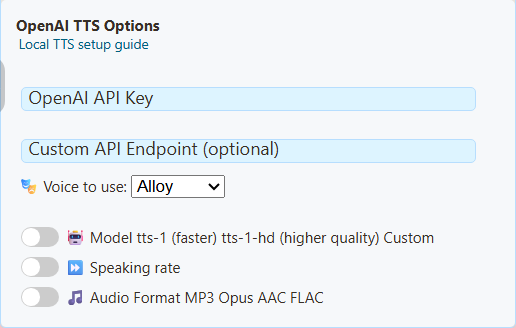
TTS personalizado / local
Esta opção reutiliza os controles compatíveis com OpenAI, então o título ainda diz OpenAI. Insira o endpoint do servidor e a voz/modelo compatíveis; a autenticação depende do servidor. Consulte o guia de servidor local.
Avançado: editar uma URL de TTS manualmente
Bons primeiros testes:
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kokoro
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=piper
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kitten
Para português ou espanhol, comece com uma destas opções:
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=piper&pipervoice=pt_BR-faber-medium
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=espeak&espeakvoice=pt-br
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=piper&pipervoice=es_ES-davefx-medium
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=espeak&espeakvoice=es
Avançado: executar seu próprio servidor local de TTS
Um servidor local de TTS é útil quando você quer vozes privadas, um modelo específico de voz ou um servidor como Kokoro-FastAPI ou openedai-speech. A página que reproduz o TTS precisa conseguir acessar o endpoint.

dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=af_bella
localhost significa o computador que executa a página. Se o servidor de TTS estiver em outro computador, use o IP dele na rede local ou execute a ponte no computador do OBS.