
1. Chatvorlesen einschalten
Noch kein Chat verbunden? Hier beginnen: SSN installieren, Quelle hinzufügen und Dock öffnen.
Öffne SSN-Erweiterungs-Popup oder den Bereich der Desktop-App Quellen und Einstellungen.
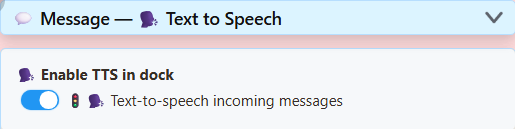
Unter Hauptchat-Overlay und Steuerungsdock, klappe Nachricht — Sprachausgabe auf. Aktiviere den hier gezeigten Schalter:
2. Kostenlose Stimme wählen
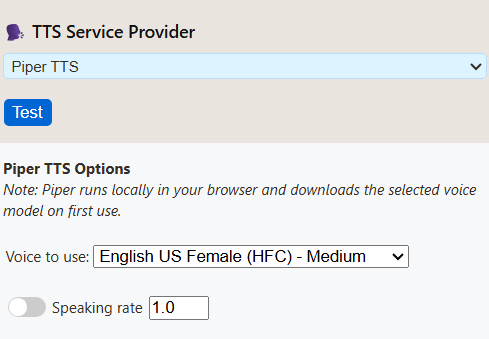
Scrolle im selben Bereich zu TTS-Anbieter. Wähle Piper TTS, dann eine Stimme.
Verwende Link kopieren neben Hauptchat-Overlay und Steuerungsdock um deinen aktualisierten Link zu erhalten.
3. In OBS abspielen
- Füge in OBS eine Browserquelle hinzu und füge diesen Link ein.
- Aktivieren Audio über OBS steuern (Control audio via OBS) in ihren Eigenschaften.
- Sende eine Chatnachricht. Prüfe den Audiopegel der Quelle und erstelle dann eine kurze Aufnahme.
Möchtest du es selbst hören? Wähle in den erweiterten Audioeigenschaften von OBS Monitor und Ausgabe für diese Quelle. Lasse nur eine Instanz den Chat vorlesen.
Kostenlose Stimmen anhören
Lieber ein anderer Klang? Diese vier Stimmen sind kostenlos. Drücke zum Vergleichen auf Abspielen.
Piper
Englisch USA, weiblich (HFC), mittlere Qualität.en_US-hfc_female-medium
Kokoro
Bella, amerikanisch, weiblich. Mit CPU/WASM, q8 getestet.af_bella
Kitten
Stimme 4, weiblich. Mitgeliefertes Modell nano v0.1.expr-voice-4-f
eSpeak
Englisch. Eine synthetische Stimme mit geringem Ressourcenbedarf.en
Spanische und portugiesische Beispiele
Wähle in den SSN-Einstellungen über der Stimmenliste eine Sprache und verwende dann Testen. Piper bietet Spanien, Mexiko, Brasilien und Portugal; Kokoro ergänzt drei spanische und drei brasilianisch-portugiesische Stimmen.
Piper - Spanisch (Spanien)
DaveFX
Kokoro - Spanisch
Dora
Piper - Portugiesisch (Brasilien)
Faber
Kokoro - Portugiesisch (Brasilien)
Dora
Kostenlose lokale Synthese mit anfänglichem Download. Beispiele enthalten keine Ladezeit. Piper ist der ressourcenschonendere Einstieg; Kokoro kann auf der CPU langsam sein. Verwende Piper, wenn die Sprachausgabe hinter dem Chat zurückbleibt.
Beispieltexte und Testdetails
Die vier englischen Beispiele lesen: Willkommen im Stream! Danke, dass ihr dabei seid. Welches Spiel sollen wir als Nächstes spielen? Vorlesen von Namen ist deaktiviert.
Am 7. September 2026 in OBS 32.2.2 unter Windows 11 geprüft: Eine Chatnachricht erreichte das echte Dock, erzeugte Sprache, bewegte den Pegel der Browser-Quelle und war in einer Aufnahme zu hören. Kokoro brauchte in diesem CPU-Test merklich länger bis zum Sprechbeginn. Diese Clips zeigen die Stimme, nicht die Wartezeit.
System TTS stellte auf diesem Rechner fünf Stimmen bereit, erzeugte aber kein Audio in der Browser-Quell-Aufnahme. Dieses Ergebnis gilt für diese Einrichtung; teste immer deine endgültige URL und Aufnahme. Cloud-Stimmen sind nicht enthalten, da keine kostenpflichtigen Zugangsdaten verwendet wurden.
Brauchst du Hilfe?
Unterstützt meine Chatplattform TTS?
Wenn SSN den Chat als Text empfängt, kann es ihn vorlesen. YouTube, Twitch, TikTok und andere Quellen verwenden dieselbe Funktion. Deine Chatplattform braucht keine eigene TTS-Unterstützung.
Keine Sprachausgabe?
Prüfe, ob das Dock Chat empfängt, und kontrolliere dann TTS-Schalter, Anbieter und Filter. Verwende den frisch kopierten Link. Lasse den ersten Modelldownload abschließen.
Funktioniert in Chrome/Edge, aber nicht in OBS?
OBS hat einen eigenen Browser und eine eigene Stimmenliste. System TTS funktioniert dort möglicherweise nicht, selbst wenn Stimmen aufgeführt werden. Probiere Piper, Kokoro, Kitten oder eSpeak. Ein virtuelles Audiokabel behebt fehlende Sprachausgabe nicht.
Der Pegel bewegt sich, aber die Aufnahme bleibt stumm?
Prüfe Stummschaltung und Aufnahmespur-Zuordnungen in OBS. Wähle „Monitor und Ausgabe“, wenn du es auch selbst hören möchtest; erfasse diese Monitorausgabe nicht ein zweites Mal. OBS-Audioanleitung.
Kann ich stattdessen ein OBS-Dock oder Featured Chat verwenden?
Ein benutzerdefiniertes OBS-Browser-Dock ist ein Bedienfeld, nicht die oben verwendete Browser-Quelle einer Szene. Aktiviere für Featured Chat TTS in dessen eigenen Popup-Optionen und kopiere seinen Link. Lasse nur eine Seite sprechen, um doppelte Stimmen zu vermeiden.
Alle Anbieter vergleichen: Anforderungen, Kosten und Abwägungen
Beginne mit Piper für eine kostenlose lokale Stimme oder vergleiche Kokoro, wenn dir dessen Klang besser gefällt. Probiere eSpeak, wenn Reaktionsgeschwindigkeit wichtiger ist als Realismus. Kitten ist eine weitere kompakte englische Option. Höre sie vor der Entscheidung an.
| Anbieter | Gut für | Abwägung | Anforderungen / Kosten |
|---|---|---|---|
| Kokoro | Englische, spanische und brasilianisch-portugiesische Stimmen. | Mehr CPU-Arbeit; die erste Sprachausgabe kann langsam sein. | Kostenlos, ohne Schlüssel. Lädt Modell-/Stimmenressourcen herunter; CPU oder unterstütztes WebGPU. |
| Piper | Lokale neuronale Stimmen; Optionen für Englisch, Spanisch und Portugiesisch. | Qualität und Aussprache unterscheiden sich je nach Stimme. | Kostenlos, ohne Schlüssel. Lädt das gewählte Modell herunter (HFC medium: etwa 63 MB), plus Engine-Dateien. |
| Kitten | Kompaktes englisches Modell, acht Stimmen zur Auswahl. | Weniger Sprachen und Stimmenstile. | Kostenlos, ohne Schlüssel. Aktuell enthaltenes Modell: etwa 24 MB plus Engine-/Stimmendateien; CPU. |
| eSpeak | Ressourcenschonend, viele Sprachen, schneller Start. | Bewusst synthetischer/robotischer Klang. | Kostenlos, ohne Schlüssel. Lädt mitgelieferte Engine-/Sprachdateien; kein neuronales Modell oder GPU erforderlich. |
| System-Sprachausgabe | Verwendet Stimmen, die dein Browser oder die Desktop-App bereitstellt. | Stimmenliste und OBS-Erfassung variieren; einige Stimmen benötigen Internet. | Keine SSN-Anbietergebühr. Benötigt eine funktionierende System-/Browserstimme; teste auf der tatsächlichen Wiedergabeseite. |
| ElevenLabs | Stimmen-IDs, Modellauswahl und Stabilitäts-/Stilsteuerungen. | Kontolimits, Netzwerkverzögerung und API-Gebühren können anfallen. | Internet, API-Schlüssel und zugängliche Stimmen-ID. Chattext geht an den Anbieter. |
| Google Cloud | Benannte Stimmen und Steuerungen für Sprache, Geschwindigkeit und Tonhöhe. | Nicht jede Stimme unterstützt jede Steuerung. | Internet, aktivierte Cloud-TTS-API, API-Schlüssel und passende Stimme/Sprache. Abrechnung/Kontingent gelten. |
| Gemini | Stimmenstile und schriftliche Vortragsanweisungen. | Vorschaumodelle und Kontingente können sich ändern; die Latenz variiert. | Internet, Gemini-API-Schlüssel und Zugriff auf das gewählte TTS-Modell. Prüfe Kontolimits/Abrechnung. |
| Speechify | Stimmen-ID mit Steuerungen für Geschwindigkeit, Sprache und Modell. | Benötigt API-Zugriff; verfügbare Stimmen hängen vom Konto ab. | Internet und Speechify-API-Schlüssel. API-Nutzungsbedingungen und -Limits gelten. |
| OpenAI | Benannte Stimmen mit Modell- und Formatsteuerungen. | API-Abrechnung und Internet erforderlich; ein Kontoabonnement ist davon getrennt. | API-Schlüssel mit TTS-Zugriff. Chattext wird an den konfigurierten Endpunkt gesendet. |
| Benutzerdefiniert / Lokal | Verwende deinen eigenen kompatiblen Sprachserver. | Höchster Einrichtungsaufwand: Endpunkt, Modell, Stimme und Browserzugriff müssen zusammenpassen. | Ein erreichbarer OpenAI-kompatibler Sprachendpunkt; Schlüssel, falls erforderlich. Lokale Hardware- oder Hostingkosten variieren. |
Die oben genannten Downloadgrößen beziehen sich auf Modelldateien, nicht auf den gesamten Speicherbedarf oder alle erforderlichen Ressourcen. Lokale Anbieter verwenden den Computer, auf dem Dock/Overlay laufen; die erste Nutzung kann langsamer sein, und OBS hat einen eigenen Cache. Cloud-Anbieter sparen lokale Rechenleistung, senden den Text aber vom Gerät weg.
OBS: die vier folgenden lokalen Anbieter bestanden Aufnahmetests mit Browser-Quellen. Cloud-/eigene Anbieter liefern Audio zur Wiedergabe auf der Seite, wurden bei dieser Prüfung aber nicht mit echten Konten getestet. System TTS benötigt einen separaten Test, selbst wenn Stimmen aufgeführt werden.
Anbietereinstellungen und Stimmennamen
Tatsächliche Desktop-App-Einstellungen, mit einem frischen Profil aufgenommen. Öffne den gewünschten Anbieter; die API-Schlüsselfelder sind absichtlich leer. Diese Steuerungen konfigurieren das ausgewählte SSN-Dock oder Overlay. Wähle einen Screenshot, um ihn in voller Größe zu sehen.
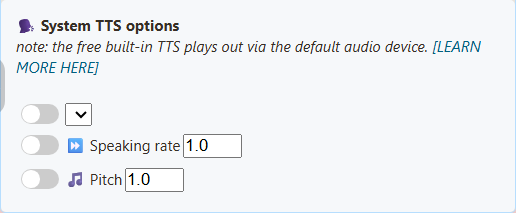
System-Sprachausgabe
Die Sprachenliste ist in diesem frischen Profil leer. Verfügbare Stimmen hängen von Browser/App und installierten Stimmen ab; es gibt keine universelle SSN-Stimmenliste.
Kokoro
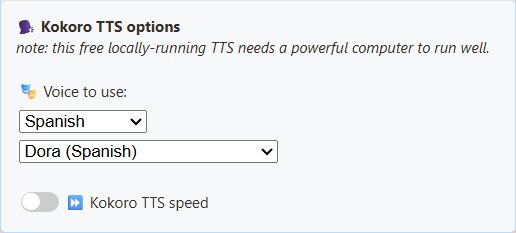
Wähle eine Stimme in SSN; das Modell wird auf der sprechenden Seite geladen. Die Auswahl enthält US-/UK-Englisch, Spanisch und brasilianisches Portugiesisch. Finde Stimmen über den Sprachfilter; Test spielt einen kurzen Satz in der gewählten Sprache. Probiere Piper für geringere CPU-Last.
Stimmennamen und URL-Werte
- Heart (amerikanisch, weiblich) —
af_heart - Alloy (amerikanisch, weiblich) —
af_alloy - Aoede (amerikanisch, weiblich) —
af_aoede - Bella (amerikanisch, weiblich) —
af_bella - Jessica (amerikanisch, weiblich) —
af_jessica - Kore (amerikanisch, weiblich) —
af_kore - Nicole (amerikanisch, weiblich) —
af_nicole - Nova (amerikanisch, weiblich) —
af_nova - River (amerikanisch, weiblich) —
af_river - Sarah (amerikanisch, weiblich) —
af_sarah - Sky (amerikanisch, weiblich) —
af_sky - Adam (amerikanisch, männlich) —
am_adam - Echo (amerikanisch, männlich) —
am_echo - Eric (amerikanisch, männlich) —
am_eric - Fenrir (amerikanisch, männlich) —
am_fenrir - Liam (amerikanisch, männlich) —
am_liam - Michael (amerikanisch, männlich) —
am_michael - Onyx (amerikanisch, männlich) —
am_onyx - Puck (amerikanisch, männlich) —
am_puck - Santa (amerikanisch, männlich) —
am_santa - Emma (britisch, weiblich) —
bf_emma - Isabella (britisch, weiblich) —
bf_isabella - George (britisch, männlich) —
bm_george - Lewis (britisch, männlich) —
bm_lewis - Alice (britisch, weiblich) —
bf_alice - Lily (britisch, weiblich) —
bf_lily - Daniel (britisch, männlich) —
bm_daniel - Fable (britisch, männlich) —
bm_fable - Dora (Spanisch) -
ef_dora - Alex (Spanisch) -
em_alex - Santa (Spanisch) -
em_santa - Dora (brasilianisches Portugiesisch) -
pf_dora - Alex (brasilianisches Portugiesisch) -
pm_alex - Santa (brasilianisches Portugiesisch) -
pm_santa
Kitten
Acht englische Stimmen: männliche und weibliche Varianten mit den Nummern 2, 3, 4 und 5. Das Beispiel verwendet Voice 4 (Female).
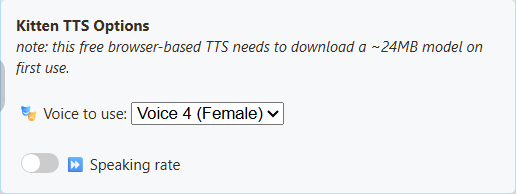
Stimmennamen und URL-Werte
- Stimme 2 (männlich) —
expr-voice-2-m - Stimme 2 (weiblich) —
expr-voice-2-f - Stimme 3 (männlich) —
expr-voice-3-m - Stimme 3 (weiblich) —
expr-voice-3-f - Stimme 4 (männlich) —
expr-voice-4-m - Stimme 4 (weiblich) —
expr-voice-4-f - Stimme 5 (männlich) —
expr-voice-5-m - Stimme 5 (weiblich) —
expr-voice-5-f
Piper
Wähle eine passende Sprache und ein passendes Modell. Das Beispiel verwendet HFC medium. Eine Spracheinstellung allein übersetzt keine Stimme.
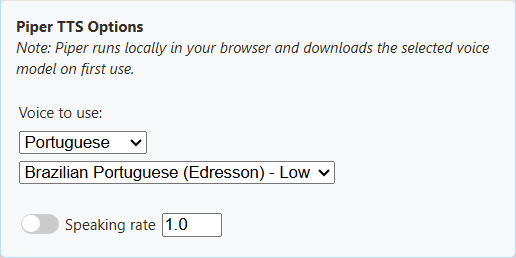
Stimmennamen und URL-Werte
- Englisch USA, weiblich (HFC) - mittlere Qualität —
en_US-hfc_female-medium - Spanisch Spanien (DaveFX) - mittlere Qualität —
es_ES-davefx-medium - Spanisch Mexiko (Ald) - mittlere Qualität —
es_MX-ald-medium - Brasilianisches Portugiesisch (Faber) - mittlere Qualität —
pt_BR-faber-medium - Brasilianisches Portugiesisch (Edresson) - niedrige Qualität —
pt_BR-edresson-low - Portugiesisch Portugal (Tugao) - mittlere Qualität —
pt_PT-tugão-medium
eSpeak
Wähle eine Stimme für die Sprache und passe optional die Sprechgeschwindigkeit an. Diese Engine klingt bewusst robotisch.
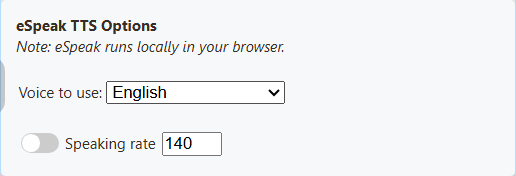
Stimmennamen und URL-Werte
- Englisch —
en - Spanisch —
es - Portugiesisch Brasilien —
pt-br - Portugiesisch Portugal —
pt-pt
ElevenLabs
Gib deinen API-Schlüssel ein und verwende dann „List My Available Voices“, um eine für dein Konto verfügbare Stimmen-ID zu finden. Anbieterreferenz.
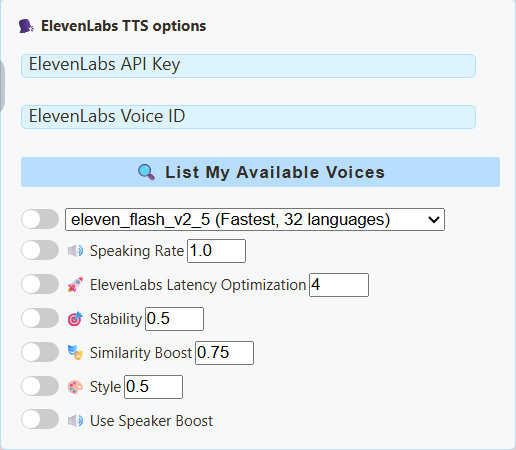
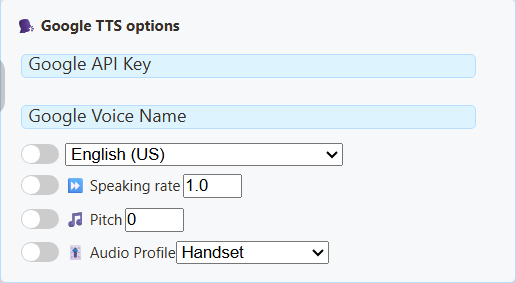
Google Cloud
Gib einen Google-Cloud-TTS-API-Schlüssel und den exakten Stimmennamen mit passender Sprache ein. Stimmennamen und unterstützte Steuerungen.
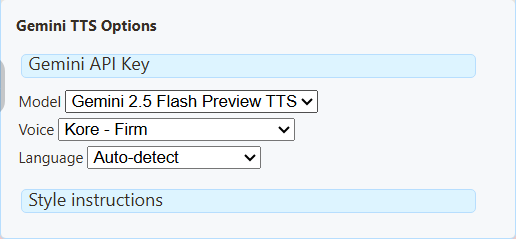
Gemini
Wähle ein unterstütztes TTS-Modell und eine Stimme; Stilanweisungen ändern den Vortrag. Dies sind Gemini-API-Einstellungen, getrennt von Google Cloud TTS. Stimmenbeispiele und Anforderungen.
Fish Audio
Auswählen Fish Audio im TTS-Anbietermenü für Chat-Dock, Featured-Overlay, TTS-Seite oder Flow Actions. Gib deinen eigenen Fish-Audio-API-Schlüssel, verwende dann die vorhandene Schaltfläche „Test TTS“. Eine optionale Voice ID wählt eine Stimme aus Fish Audio; kopiere die Stimmenmodell-ID, nicht ihren Namen oder die Seiten-URL. Lasse sie leer, um die Standardstimme des Dienstes zu verwenden.
Zu den erweiterten Optionen gehören Modell und Sprechgeschwindigkeit (0,5–2). SSN verwendet standardmäßig s2.1-pro-free; Verfügbarkeit des kostenlosen Angebots und Fair-Use-Bedingungen werden von Fish Audio bestimmt. Bezahlte Modelle benötigen Kontoguthaben. SSN wiederholt eine fehlgeschlagene kostenlose Anfrage nicht mit einem bezahlten Modell. Verwende „More TTS options“ für die Zuschauerlautstärke. Text wird an Fish Audio gesendet; die Sprache erkennt der Dienst.
OBS-/Browser-Einrichtung: Starte die vorhandene lokale TTS-Brücke von SSN im Fish-Modus auf dem OBS-Computer. Setze ihre Umgebungsvariable SSN_TTS_TARGET_BEARER auf deinen Fish-API-Schlüssel und starte node scripts/local-tts-bridge.cjs --mode fish. Setze im Fish-Audio-Bereich Bridge-URL für OBS/Browser auf http://127.0.0.1:8124/v1/audio/speech; füge das im Terminal ausgegebene lokale Bridge-Token in das Popup-Feld API-Schlüssel ein. Das Token ändert sich beim Neustart, sofern du nicht SSN_TTS_BRIDGE_TOKEN auf ein langes zufälliges Geheimnis setzt; halte Overlay-Links mit Token geheim. Lasse die Brücke laufen, teste die Stimme und verwende die erzeugte Overlay-URL in OBS. Aktiviere „Audio über OBS steuern“ in den Browser-Quell-Einstellungen, wenn du das Audio im OBS-Mixer möchtest. Direkte Fish-Anfragen von gehosteten Browserseiten haben keine CORS-Berechtigung; die Brücke liefert die für den Browser zugängliche Audioantwort.
Füge mit der Brücke &fishendpoint=http%3A%2F%2F127.0.0.1%3A8124%2Fv1%2Faudio%2Fspeech zur URL hinzu und lasse fishkey weg, wenn die Brücke den Schlüssel enthält.
URL-Parameter: &ttsprovider=fish&fishkey=YOUR_KEY&voicefish=VOICE_ID&fishmodel=s2.1-pro-free&fishspeed=1. Aktiviere TTS über die üblichen Steuerungen. Halte erzeugte URLs mit deinem Schlüssel geheim. Die bestehende Stimmenüberschreibung von Speak Text in Event Flow akzeptiert eine Fish-Stimmen-ID, wenn die empfangende Seite Fish Audio verwendet.
Fish-Audio-API-Referenz · Ankündigung und Bedingungen des kostenlosen Modells
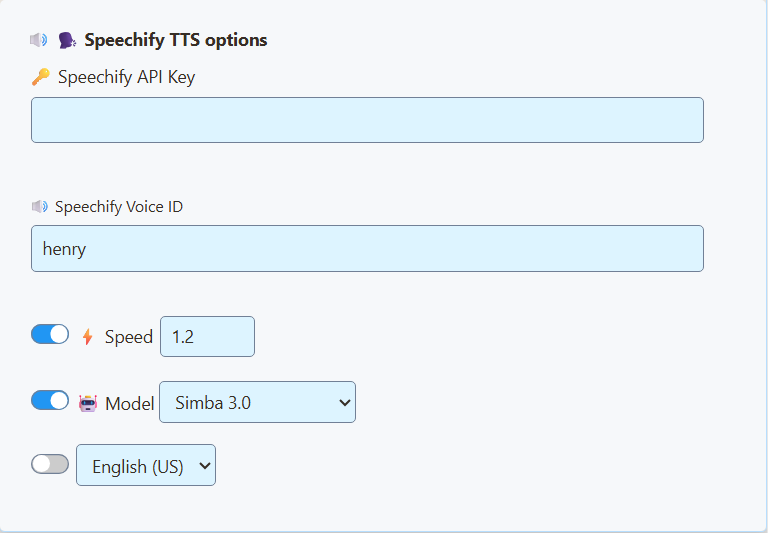
Speechify
Gib den API-Schlüssel und die Stimmen-ID aus deinem Speechify-API-Konto ein. Anbietereinrichtung.
OpenAI
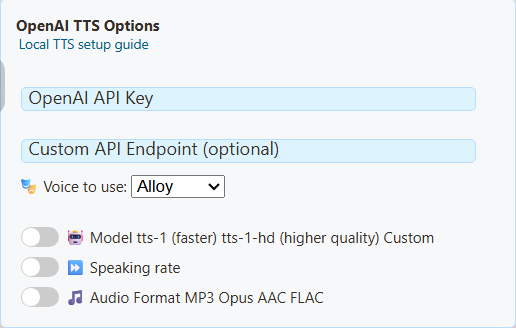
Wähle eine unterstützte Stimme/ein unterstütztes Modell und gib einen API-Schlüssel ein. Ein ChatGPT-Abonnement enthält kein API-Guthaben. Behalte für OpenAI den Standardendpunkt.
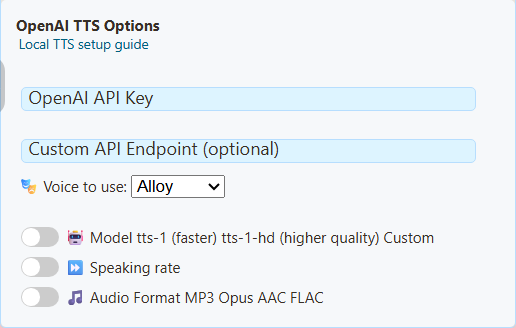
Benutzerdefinierte / lokale TTS
Diese Option verwendet die OpenAI-kompatiblen Steuerungen, daher lautet die Überschrift weiterhin OpenAI. Gib deinen Serverendpunkt und die unterstützte Stimme/das Modell ein; die Authentifizierung hängt von deinem Server ab. Siehe die Anleitung für lokale Server.
Erweitert: TTS-URL manuell bearbeiten
Gute erste Tests:
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kokoro
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=piper
dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=kitten
Beginne für Portugiesisch oder Spanisch stattdessen mit einer dieser Optionen:
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=piper&pipervoice=pt_BR-faber-medium
dock.html?session=YOUR_SESSION&speech=pt-BR&ttsprovider=espeak&espeakvoice=pt-br
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=piper&pipervoice=es_ES-davefx-medium
dock.html?session=YOUR_SESSION&speech=es-ES&ttsprovider=espeak&espeakvoice=es
Erweitert: Eigenen lokalen TTS-Server betreiben
Ein lokaler TTS-Server ist nützlich, wenn du private Stimmen, ein bestimmtes Stimmenmodell oder einen Server wie Kokoro-FastAPI oder openedai-speech möchtest. Die Seite, die TTS abspielt, muss den Endpunkt erreichen können.

dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=customtts&openaiendpoint=http://127.0.0.1:8124/v1/audio/speech&voiceopenai=af_bella
localhost bezeichnet den Computer, auf dem die Seite läuft. Wenn dein TTS-Server auf einem anderen Computer läuft, verwende dessen LAN-IP oder betreibe die Brücke auf dem OBS-Computer.