
الإعداد في 5 خطوات
لم توصل الدردشة بعد؟ ابدأ هنا أولاً.
- افتح النافذة المنبثقة لإضافة SSN، أو المصادر والإعدادات في تطبيق سطح المكتب.
- ضمن تراكب الدردشة الرئيسي ولوحة التحكم، وسّع Message – Text to Speech.
- فعّل قراءة الرسائل الواردة بصوت.
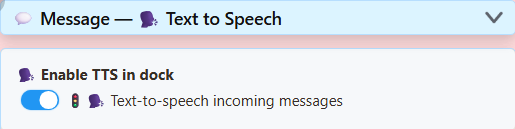
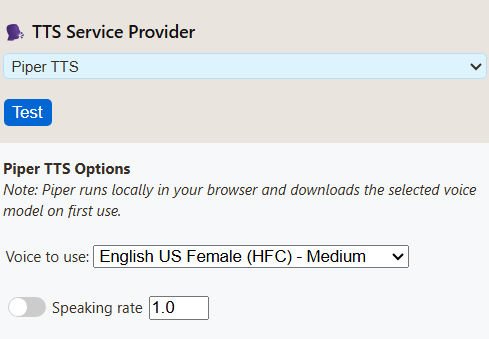
- مرّر إلى مزوّد خدمة تحويل النص إلى كلام. اختر Piper TTS، ثم صوتًا.
- انقر على نسخ الرابط بجوار تراكب الدردشة الرئيسي ولوحة التحكم.
تشغيله في OBS
- أضف مصدر المتصفح والصق الرابط الذي نسخته.
- في خصائصه، فعّل التحكم بالصوت عبر OBS (Control audio via OBS).
- أرسل رسالة دردشة. ينبغي أن يتحرك عداد الصوت للمصدر.
- سجل اختباراً قصيراً وشغّله.
استمع إلى الأصوات المجانية
الأربعة مجانية وتعمل على حاسوبك. اضغط التشغيل للمقارنة.
Kokoro
Bella، إنجليزية أمريكية، أنثى. الأكثر طبيعية، لكنها أبطأ على المعالج.af_bella
عينات بالإسبانية والبرتغالية
اختر لغة فوق قائمة الأصوات في SSN، ثم اضغط اختبار. يوفر Piper أصواتاً لإسبانيا والمكسيك والبرازيل والبرتغال. يوفر Kokoro ثلاثة أصوات إسبانية وثلاثة برتغالية برازيلية.
Piper - الإسبانية (إسبانيا)
DaveFX
Kokoro - الإسبانية
Dora
Piper - البرتغالية (البرازيل)
Faber
Kokoro - البرتغالية (البرازيل)
Dora
Piper الخيار الأخف. إذا تأخر Kokoro عن الدردشة، انتقل إلى Piper.
كيف أُعدت هذه العينات
تقرأ العينات الإنجليزية: مرحبًا بكم في البث! شكرًا لانضمامكم إلينا. أي لعبة ينبغي أن نلعب بعد ذلك؟ كانت قراءة الاسم معطلة. المقاطع لا تتضمن وقت التحميل.
اختُبر في 7 سبتمبر 2026 على OBS 32.2.2 وWindows 11. وصلت رسالة دردشة حقيقية إلى Dock ونُطقت وحركت عداد Browser Source وظهرت في تسجيل. استغرق Kokoro وقتاً أطول ملحوظاً للبدء على المعالج.
على ذلك الحاسوب، عرض System TTS خمسة أصوات لكنه لم يُنتج صوتاً في تسجيل OBS. قد يختلف حاسوبك؛ اختبر رابطك دائماً. لم تُختبر الأصوات السحابية لعدم وجود حسابات مدفوعة.
اختر مزوداً
ابدأ بـ Piper. جرّب Kokoro إن فضّلت صوته. تعمل الأصوات المجانية على حاسوبك. تحتاج الأصوات السحابية إلى حساب ومفتاح API وتُرسل الدردشة إلى تلك الشركة.
| المزود | مناسب لـ | تذكّر | التكلفة |
|---|---|---|---|
| Piper | أصوات طبيعية؛ إنجليزية وإسبانية وبرتغالية. | تختلف الجودة بحسب الصوت. HFC medium نحو 63 MB. | مجاني دون مفتاح |
| Kokoro | الأصوات المجانية الأكثر طبيعية؛ إنجليزية وإسبانية وبرتغالية برازيلية. | أثقل على المعالج وقد يتأخر أول كلام. أسرع ببطاقة رسومية مدعومة. | مجاني دون مفتاح |
| Kitten | نموذج إنجليزي صغير بثمانية أصوات. | الإنجليزية فقط. النموذج المرفق نحو 24 MB. | مجاني دون مفتاح |
| eSpeak | خفيف جداً، متعدد اللغات، يبدأ سريعاً. | صوت آلي عن قصد. | مجاني دون مفتاح |
| تحويل النص إلى كلام في النظام | أصوات موجودة بالفعل في متصفحك أو حاسوبك. | غالباً صامت في OBS. تحتاج بعض الأصوات إلى الإنترنت. | مجاني |
| ElevenLabs | اختر الأصوات بالمعرّف؛ تحكم بالثبات والأسلوب. | حدود الحساب وتأخر الشبكة. | قد تُطبّق رسوم API |
| Google Cloud | أصوات مسماة؛ لغة وسرعة وطبقة صوت. | لا يدعم كل صوت جميع عناصر التحكم. يجب تفعيل Cloud TTS API. | تُطبّق الفوترة والحصص |
| Gemini | أنماط أصوات وتعليمات إلقاء مكتوبة. | قد تتغير نماذج المعاينة والحصص. | تحقق من حدود Gemini |
| Fish Audio | نموذج مجاني بمفتاحك الخاص؛ معرّفات أصوات. | يحتاج OBS إلى جسر SSN المحلي. | تحدد Fish Audio الفئة المجانية |
| Speechify | معرّف صوت مع السرعة واللغة والنموذج. | تعتمد الأصوات على حسابك. | تُطبّق شروط API |
| OpenAI | أصوات مسماة وتحكم بالنموذج والصيغة. | اشتراك ChatGPT لا يتضمن رصيد API. | فوترة API |
| مخصص / محلي | خادم الأصوات الخاص بك. | يحتاج أكبر قدر من الإعداد. راجع دليل الخادم المحلي. | أجهزتك أو استضافتك |
أحجام التنزيل وملاحظات اختبار OBS
الأحجام لملفات النماذج فقط وليست استهلاك الذاكرة. تعمل الأصوات المجانية على الحاسوب الذي يشغّل Dock أو التراكب. أول استخدام أبطأ. يحتفظ OBS بذاكرة تنزيل مؤقتة مستقلة عن Chrome.
اجتازت Piper وKokoro وKitten وeSpeak اختبارات تسجيل Browser Source في OBS. تعمل الأصوات السحابية والمخصصة عبر الصفحة أيضاً، لكنها لم تُختبر بحسابات حية. اختبر System TTS منفرداً حتى إن عرض أصواتاً.
حل المشكلات
| المشكلة | جرّب هذا |
|---|---|
| هل تدعم منصة الدردشة لدي تحويل النص إلى كلام؟ | نعم، إذا تلقى SSN الدردشة كنص. تعمل YouTube وTwitch وTikTok وغيرها بالطريقة نفسها. لا تحتاج المنصة إلى TTS خاص بها. |
| لا صوت مطلقاً | تأكد من أن Dock يعرض الدردشة، ثم افحص مفتاح TTS والمزود والمرشحات. استخدم رابطاً منسوخاً حديثاً ودع تنزيل الصوت الأول يكتمل. |
| يعمل في Chrome أو Edge، وليس في OBS | لدى OBS متصفحه وقائمة أصواته الخاصة، وغالباً لا يعمل System TTS فيه. انتقل إلى Piper أو Kokoro أو Kitten أو eSpeak. لا يصلح كابل صوت افتراضي غياب توليد الكلام. |
| يتحرك العداد لكن التسجيل صامت | تحقق من الكتم ومسارات التسجيل في OBS. لا تلتقط خرج المراقبة مرة ثانية. راجع دليل صوت OBS. |
| الكلام يتأخر عن الدردشة | انتقل من Kokoro إلى Piper أو جرّب eSpeak. |
| تُقرأ كل رسالة مرتين | أكثر من صفحة تتكلم. أبقِ TTS مفعلاً في مكان واحد فقط. |
| أريد أن يتكلم Dock في OBS أو Featured Chat بدلاً منه | Custom Browser Dock في OBS لوحة تحكم، وليس مصدراً في المشهد. لـ Featured Chat، فعّل TTS من خيارات التراكب نفسه وانسخ رابطه. |
حلول إضافية: مرجع TTS · مشكلات الخادم المحلي.
إعدادات المزود
لقطات فعلية من تطبيق سطح المكتب بملف تعريف جديد وحقول المفاتيح فارغة. افتح مزوداً لرؤية إعداداته. انقر اللقطة لتكبيرها.
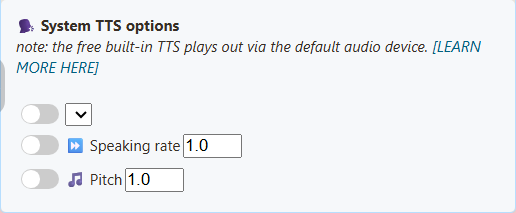
تحويل النص إلى كلام في النظام
تعتمد قائمة الأصوات على المتصفح أو التطبيق والأصوات المثبتة. لا توجد قائمة ثابتة لدى SSN. عرض ملف التعريف الجديد هذا قائمة لغات فارغة.
Kokoro
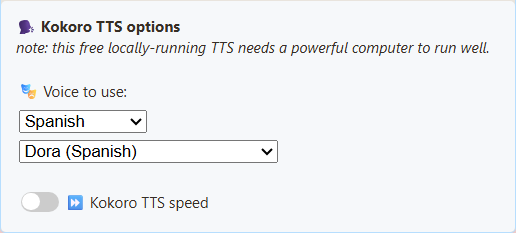
اختر صوتاً. استخدم مرشح اللغة للعثور عليه، و اختبار لسماعه. يُحمّل النموذج على الصفحة التي تتكلم. الأصوات: إنجليزية أمريكية وبريطانية وإسبانية وبرتغالية برازيلية. بطيء جداً؟ جرّب Piper.
أسماء الأصوات وقيم الروابط
- Heart (أنثى أمريكية) —
af_heart - Alloy (أنثى أمريكية) —
af_alloy - Aoede (أنثى أمريكية) —
af_aoede - Bella (أنثى أمريكية) —
af_bella - Jessica (أنثى أمريكية) —
af_jessica - Kore (أنثى أمريكية) —
af_kore - Nicole (أنثى أمريكية) —
af_nicole - Nova (أنثى أمريكية) —
af_nova - River (أنثى أمريكية) —
af_river - Sarah (أنثى أمريكية) —
af_sarah - Sky (أنثى أمريكية) —
af_sky - Adam (ذكر أمريكي) —
am_adam - Echo (ذكر أمريكي) —
am_echo - Eric (ذكر أمريكي) —
am_eric - Fenrir (ذكر أمريكي) —
am_fenrir - Liam (ذكر أمريكي) —
am_liam - Michael (ذكر أمريكي) —
am_michael - Onyx (ذكر أمريكي) —
am_onyx - Puck (ذكر أمريكي) —
am_puck - Santa (ذكر أمريكي) —
am_santa - Emma (أنثى بريطانية) —
bf_emma - Isabella (أنثى بريطانية) —
bf_isabella - George (ذكر بريطاني) —
bm_george - Lewis (ذكر بريطاني) —
bm_lewis - Alice (أنثى بريطانية) —
bf_alice - Lily (أنثى بريطانية) —
bf_lily - Daniel (ذكر بريطاني) —
bm_daniel - Fable (ذكر بريطاني) —
bm_fable - Dora (إسبانية):
ef_dora - Alex (إسبانية):
em_alex - Santa (إسبانية):
em_santa - Dora (برتغالية برازيلية):
pf_dora - Alex (برتغالية برازيلية):
pm_alex - Santa (برتغالية برازيلية):
pm_santa
Kitten
ثمانية أصوات إنجليزية: نسخ ذكورية وأنثوية للأصوات 2 و3 و4 و5. تستخدم العينة Voice 4 (Female).
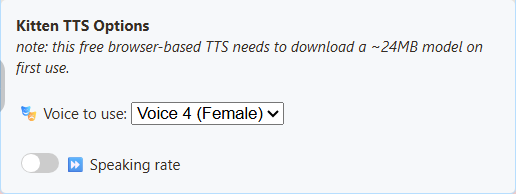
أسماء الأصوات وقيم الروابط
- الصوت 2 (ذكر) —
expr-voice-2-m - الصوت 2 (أنثى) —
expr-voice-2-f - الصوت 3 (ذكر) —
expr-voice-3-m - الصوت 3 (أنثى) —
expr-voice-3-f - الصوت 4 (ذكر) —
expr-voice-4-m - الصوت 4 (أنثى) —
expr-voice-4-f - الصوت 5 (ذكر) —
expr-voice-5-m - الصوت 5 (أنثى) —
expr-voice-5-f
Piper
اختر صوتاً يطابق لغتك. تغيير اللغة وحدها لا يغير الصوت. تستخدم العينة HFC medium.
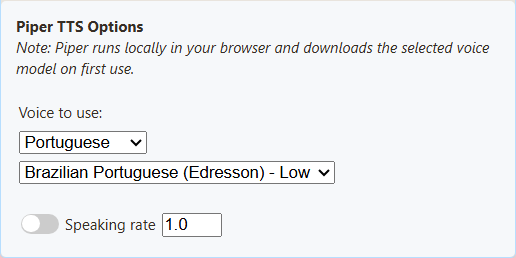
أسماء الأصوات وقيم الروابط
- أنثى إنجليزية أمريكية (HFC) - جودة متوسطة —
en_US-hfc_female-medium - الإسبانية الأوروبية (DaveFX) - جودة متوسطة —
es_ES-davefx-medium - الإسبانية المكسيكية (Ald) - جودة متوسطة —
es_MX-ald-medium - البرتغالية البرازيلية (Faber) - جودة متوسطة —
pt_BR-faber-medium - البرتغالية البرازيلية (Edresson) - جودة منخفضة —
pt_BR-edresson-low - البرتغالية الأوروبية (Tugao) - جودة متوسطة —
pt_PT-tugão-medium
eSpeak
اختر صوتاً للغة. يمكنك تغيير سرعة الكلام. صوته آلي عمداً.
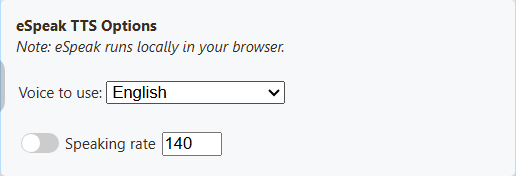
أسماء الأصوات وقيم الروابط
- الإنجليزية —
en - الإسبانية —
es - البرتغالية البرازيلية —
pt-br - البرتغالية الأوروبية —
pt-pt
ElevenLabs
أدخل مفتاح API ثم انقر عرض أصواتي المتاحة للعثور على معرّف صوت يستطيع حسابك استخدامه. مرجع ElevenLabs.
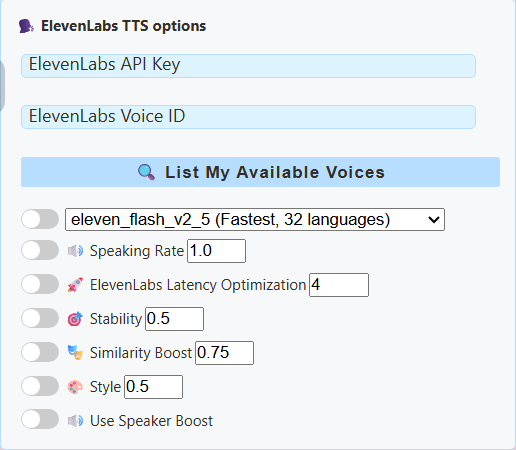
Google Cloud
أدخل مفتاح Google Cloud TTS API واسم الصوت الدقيق واللغة المطابقة. أسماء الأصوات وعناصر التحكم المدعومة.
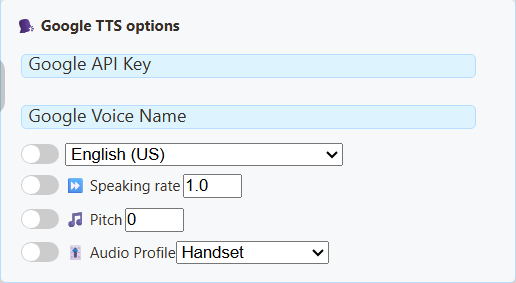
Gemini
اختر نموذج TTS وصوتاً. تغير تعليمات الأسلوب طريقة القراءة. يستخدم هذا Gemini API وليس Google Cloud TTS. أمثلة الأصوات ومتطلباتها.
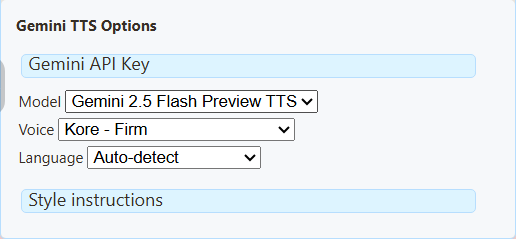
Fish Audio
يعمل في Dock الدردشة وتراكب الرسائل المميزة وصفحة TTS وإجراءات التدفق.
- اختر Fish Audio كمزود TTS.
- الصق مفتاح Fish Audio API.
- اختياري: الصق معرّف الصوت من Fish Audio. انسخ معرّف نموذج الصوت، لا اسمه أو رابط صفحته. اتركه فارغاً للصوت الافتراضي.
- اضغط اختبار TTS.
النموذج الافتراضي هو s2.1-pro-free. تحدد Fish Audio ما هو مجاني وشروط الاستخدام العادل. تحتاج النماذج المدفوعة إلى رصيد. لا ينتقل SSN إلى نموذج مدفوع إذا فشل طلب مجاني. السرعة من 0.5 إلى 2، وتكتشف Fish Audio اللغة. يُرسل نص الدردشة إليها.
لـ OBS: شغّل الجسر المحلي
تمنع Fish Audio الطلبات المباشرة من صفحات الويب، لذا يحتاج OBS إلى الجسر المحلي (يتطلب Node.js). شغّله على حاسوب OBS.
- اضبط
SSN_TTS_TARGET_BEARERإلى مفتاح Fish API لديك. - في مجلد SSN، شغّل
node scripts/local-tts-bridge.cjs --mode fish. أبقِه قيد التشغيل. - في لوحة Fish Audio، اضبط عنوان الجسر إلى
http://127.0.0.1:8124/v1/audio/speech. - الصق رمز الجسر الظاهر في الطرفية في مفتاح API المجال.
- اختبر الصوت ثم أضف رابط التراكب إلى OBS. فعّل التحكم بالصوت عبر OBS (Control audio via OBS).
SSN_TTS_BRIDGE_TOKEN إلى سر عشوائي طويل. احتفظ بالروابط التي تحتوي رمزاً أو مفتاحاً خاصة.إعدادات الرابط لـ Fish Audio
&ttsprovider=fish&fishkey=YOUR_KEY&voicefish=VOICE_ID&fishmodel=s2.1-pro-free&fishspeed=1
مع الجسر، أضف &fishendpoint=http%3A%2F%2F127.0.0.1%3A8124%2Fv1%2Faudio%2Fspeech. احذف fishkey إذا كان الجسر يحتفظ بمفتاحك. خيار Event Flow نطق النص (Speak Text) لتجاوز الصوت يقبل معرّف صوت Fish عندما تستخدم الصفحة المستقبلة Fish Audio.
Speechify
أدخل مفتاح API ومعرّف الصوت من حساب Speechify API. دليل Speechify خطوة بخطوة · إعداد Speechify.
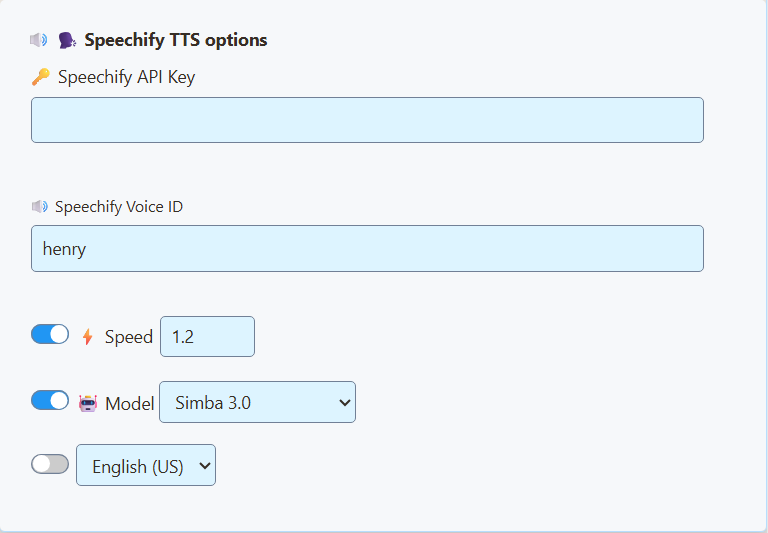
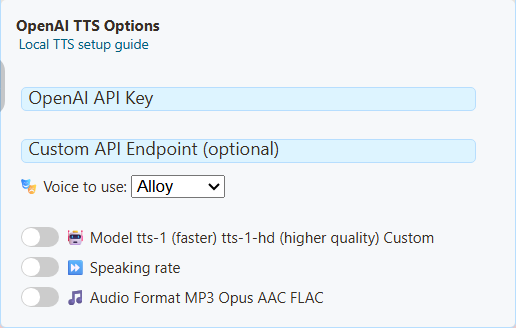
OpenAI
اختر صوتاً ونموذجاً وأدخل مفتاح API. لا يمنح اشتراك ChatGPT رصيد API. احتفظ بعنوان الاتصال الافتراضي.
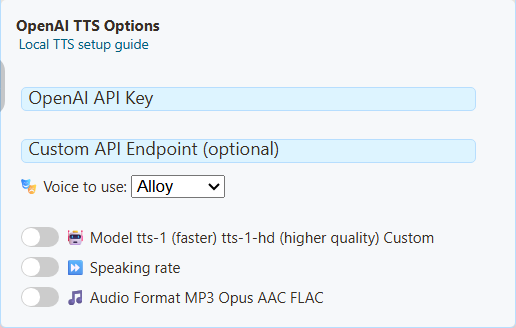
تحويل نص إلى كلام مخصص / محلي
يعيد هذا استخدام إعدادات OpenAI، لذا يبقى العنوان OpenAI. أدخل عنوان خادمك وصوتاً ونموذجاً يدعمهما. تعتمد الحاجة إلى مفتاح على خادمك. راجع دليل الخادم المحلي.
Kokoro وKitten أسرع
ضمن Kokoro أو Kitten، افتح التوليد والتشغيل. تولّد هذه الخيارات الكلام في الخلفية لتبقى الصفحة سلسة.
| أريد أن… | افعل هذا |
|---|---|
| تفعيله لـ Kokoro | اضبط المعالجة إلى التوليد في الخلفية. |
| تفعيله لـ Kitten | اختر Kitten 0.8 : Nano (الأصغر) أو Micro أو Mini. |
| سماع الكلام أسرع | التشغيل فور وصول الصوت. يشغّل كل جزء عند جهوزه. قد تتوقف الحواسيب البطيئة بين الأجزاء. |
| تجنب الفواصل | تشغيل الرسالة كاملة. ينتظر اكتمال الرسالة أولاً. |
| حل مشكلات GPU في Kokoro | اضبط معالج الخلفية إلى المعالج CPU. |
| أفضل جودة Kokoro | الجودة الكاملة. تنزيل أكبر واستخدام ذاكرة أعلى. |
تفاصيل إضافية وإعدادات الرابط
تلقائي (Automatic) يستخدم بطاقة رسومية مدعومة إن توفرت وإلا المعالج. تختار الجودة التلقائية FP16 على البطاقات المتوافقة، والدقة الكاملة على البطاقات المدعومة الأخرى، والنموذج المضغوط على المعالج. إذا فرضت GPU دون توفره، يظهر خطأ.
يعمل Kitten 0.8 على المعالج ويدعم الإنجليزية فقط. يُنزّل كل نموذج عند أول استخدام. يحتفظ كل متصفح أو OBS بنسخته الخاصة. يتلقى NeuroSync الملف الصوتي كاملاً في الحالتين. تستمر الروابط القديمة كما كانت ما لم تغير هذه الخيارات.
Kokoro: &kokororuntime=worker، والحقل الاختياري &kokoroplayback=stream, &kokorodevice=wasm أو webgpu, &kokorodtype=q8, fp16 أو fp32. يفعّل البث المتتابع أو FP32 التوليد في الخلفية تلقائياً.
Kitten: &kittenmodel=nano (أو micro, mini)، واختيارياً &kittenplayback=stream.
المزيد
| أريد أن… | اذهب هنا |
|---|---|
| تعديل رابط TTS يدوياً أو عرض كل الخيارات | مرجع TTS |
| استخدام أصوات إسبانية أو برتغالية في رابط | مرجع TTS: خيارات المزود |
| تشغيل خادم أصوات خاص أو استنساخ صوت | دليل TTS بالذكاء الاصطناعي المحلي |
| إعداد Speechify | دليل Speechify |
رابط سريع للتجربة: dock.html?session=YOUR_SESSION&speech=en-US&ttsprovider=piper